KI-Suche oder Modelltraining: Was hat Ihr Unternehmen davon?
Von Evren BalVeröffentlicht · 6 Min. Lesezeit
Seite kopieren
Ein Unternehmen veröffentlicht einen Ratgeber, weil es Menschen erreichen möchte. Ein Hersteller stellt Produktinformationen bereit, damit Interessierte das Produkt verstehen und die technische Dokumentation finden. Beide investieren in Inhalte. Ihre Erwartungen daran sind aber unterschiedlich.
An diesen Unterschied musste ich denken, als OpenAI eine gemeinsame Möglichkeit für Websites ankündigte, ihre Präferenzen zum KI-Training mitzuteilen. Das Signal soll über robots.txt übermittelt werden – eine Datei, mit der Websitebetreiber automatisierten Crawlern Vorgaben machen. OpenAI wollte das Signal laut Ankündigung in den kommenden Monaten implementieren. Ob es bereits aktiv ist, geht daraus nicht hervor.
Daraus ergibt sich für mich eine größere Frage: Worin liegt der Unterschied zwischen der Nutzung von Unternehmensinhalten in der KI-Suche und ihrer Verwendung für das Modelltraining? Und welchen Nutzen hat das Unternehmen jeweils davon?
Die Suche findet Quellen, das Training verändert ein Modell
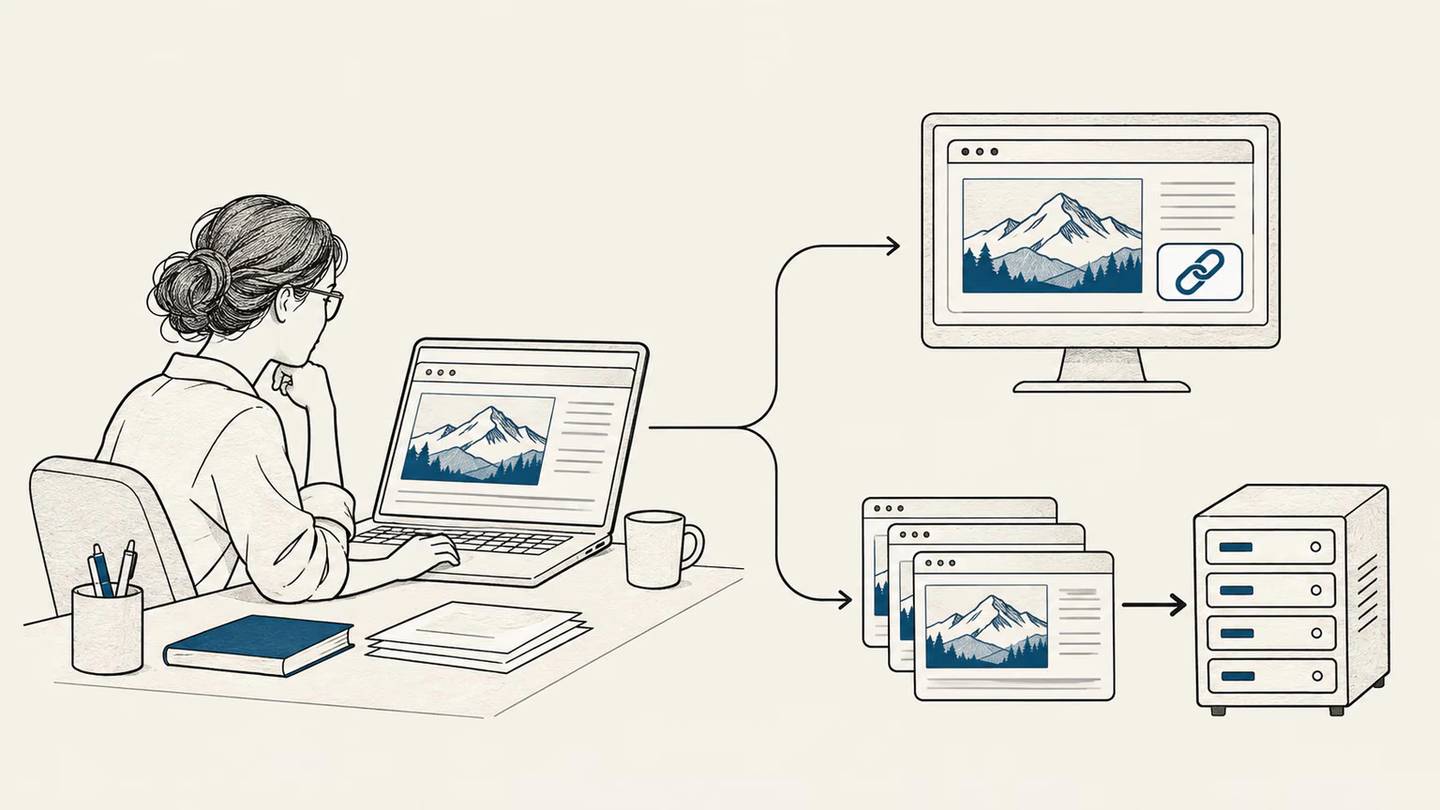
Ein KI-System kann bei einer Frage im Web suchen, eine Seite abrufen und ihre Informationen für die Antwort nutzen. Es kann auch auf die Seite verlinken. Allein die Tatsache, dass eine Seite erreichbar ist, garantiert weder, dass sie ausgewählt wird, noch dass sie als Quelle erscheint. Sie eröffnet aber die Möglichkeit, dass Nutzer die Quelle sehen und die Website besuchen.
Beim Training läuft etwas anderes ab. Ein Anbieter kann gesammelte Texte für die Entwicklung eines Modells verwenden. Das Modell lernt aus vielen Beispielen Muster und Zusammenhänge zwischen Wörtern und Ideen. Beantwortet es später eine Frage, muss es die Seite, von der eine Information stammt, oder deren Herausgeber nicht nennen. Eine Erlaubnis für das Training garantiert umgekehrt nicht, dass eine Seite tatsächlich einbezogen wird.
Nutzer können einem KI-System auch direkt einen Link geben und es um die Prüfung dieser Seite bitten. Das ist ein anderer Weg als die automatische Suche oder das Training. OpenAI beschreibt für solche vom Nutzer veranlassten Abrufe einen eigenen Agenten und weist darauf hin, dass robots.txt-Regeln dabei möglicherweise nicht gelten.
Die Crawler-Dokumentation von OpenAI beschreibt getrennte Steuerungen für GPTBot, der möglicherweise für das Training genutzte Inhalte sammelt, und OAI-SearchBot, der die ChatGPT-Suche unterstützt. Nach dieser Dokumentation kann eine Website den Trainings-Crawler blockieren und den Such-Crawler zulassen. Andere Anbieter müssen diese Trennung nicht auf dieselbe Weise anbieten.
Was erwartet eine Klinik von einem Ratgeber?
Stellen wir uns eine Klinik vor, die auf einer Seite häufige Fragen zur Nasenkorrektur beantwortet. An passender Stelle lädt sie Leserinnen und Leser ein, Kontakt aufzunehmen.
Die Klinik hat möglicherweise Zeit und Fachwissen in diese Seite investiert. Sie möchte, dass Interessierte sie finden, die Klinik kennenlernen und sich bei Bedarf melden. Eine Quellenangabe in einer KI-Suche kann der Anfang dieses Weges sein. Doch nicht jede Quellenangabe führt zu einem Besuch und nicht jeder Besuch zu einem Patienten.
Wird die Seite für das Training verwendet, könnte ein Modell später eine allgemeine Frage zur Nasenkorrektur beantworten, ohne die Klinik zu nennen. Auch die Einladung zur Kontaktaufnahme erreicht den Nutzer dann möglicherweise nicht. Das beweist weder, dass eine bestimmte Antwort von dieser Klinik gelernt wurde, noch, dass sie einen Patienten verloren hat. Es zeigt, weshalb die beiden Nutzungen einem Unternehmen unterschiedlich viel bringen können.
Allgemeine Gesundheitsinformationen können außerdem einen öffentlichen Nutzen haben. Eine Einrichtung kann es begrüßen, wenn sie damit zum allgemeinen Wissensbestand beiträgt. Ob dieser Beitrag ihrer eigenen Marke messbar nützt, ist eine andere Frage.
Eine Produktseite erfüllt eine andere Aufgabe
Nehmen wir nun einen Baustoffhersteller. Seine Produktseite nennt ein bestimmtes Produkt und beschreibt geeignete Untergründe, Anwendungsbedingungen und technische Unterlagen.
Hier stehen Marke und Produkt im Mittelpunkt der Information. Das Unternehmen möchte möglicherweise, dass eine Fachperson das Produkt dem richtigen Bedarf zuordnet und das aktuelle technische Merkblatt findet. Produktinformationen im Training könnten einem Modell helfen, Fragen zu diesem Produkt zu beantworten. Das garantiert jedoch nicht, dass es den Namen korrekt nennt, alle technischen Angaben richtig wiedergibt oder zur Quelle verlinkt.
Produktinformationen ändern sich. Eine Rezeptur, eine Anwendungsgrenze oder ein Merkblatt kann aktualisiert werden. Wir können nicht davon ausgehen, dass ein zuvor trainiertes Modell diese Änderung sofort berücksichtigt. Eine auffindbare aktuelle Produktseite und ein Verweis auf die Unterlagen des Herstellers können deshalb einen anderen Zweck erfüllen als die Aufnahme in Trainingsdaten.
Auch hier ist eine Nennung in der KI-Suche noch kein Verkauf. Die korrekte Nennung eines Produkts, der Abruf eines Merkblatts, eine Angebotsanfrage und ein Kauf sind unterschiedliche Ergebnisse.
Lässt sich eine Quellenangabe verlangen?
Inhaber von Inhalten können auf ihrer Website angeben, wie sie sich Quellenangaben wünschen, und ihre Nutzungsbedingungen nennen. Damit machen sie diese Erwartungen sichtbar. Es ist jedoch nicht sichergestellt, dass alle KI-Anbieter diese Angaben lesen und bei Antworten berücksichtigen, die solche Inhalte nutzen.
Der IETF-Entwurf für das gemeinsame Trainingssignal konzentriert sich darauf, eine Präferenz für das Training auszudrücken. Der von mir geprüfte Entwurf enthält keine Regel, die ein Modell bei jeder einschlägigen Antwort zur Verlinkung des Urhebers verpflichtet. Es handelt sich zudem um einen Internet-Draft, nicht um einen fertigen Standard.
Die Quellen eines Modelltrainings zu nennen, ist etwas anderes, als eine Seite zu verlinken, die für eine konkrete Antwort abgerufen wurde. Auch die Einordnung von Creative Commons zur Quellenangabe unterscheidet diese Fälle. Welche rechtliche Wirkung eine Lizenz oder Nutzungsbedingung hat, hängt von der Nutzung und dem anwendbaren Recht ab.
Die Steuerungen unterscheiden sich je nach Anbieter
Die Unterscheidung zwischen Training und Suche hilft bei der Entscheidung. Die Einstellmöglichkeiten der Anbieter entsprechen einander allerdings nicht genau.
Google erklärt beispielsweise, dass die Steuerung Google-Extended sowohl das Training künftiger Gemini-Modelle betrifft als auch beeinflusst, ob bestimmte Gemini-Produkte Suchinhalte zur Ergänzung ihrer Antworten nutzen können. Laut Google beeinflusst diese Einstellung weder die Aufnahme noch das Ranking in der Google-Suche.
Das hat praktische Folgen: Wer die Nutzung für das Training einschränkt, kann damit auch beeinflussen, ob einige Produkte aktuelle Inhalte zur Unterstützung ihrer Antworten verwenden dürfen. Vor einer Entscheidung sollte ein Unternehmen deshalb prüfen, welche Anbieter, Produkte und Nutzungen die jeweilige Einstellung umfasst.
Zuerst die Aufgabe jeder Seite klären
Nicht jede Seite eines Unternehmens muss dasselbe leisten. Ein Ratgeber soll vielleicht die richtige Zielgruppe erreichen. Eine Produktseite kann eine technische Entscheidung erleichtern. Bei einer eigenen Untersuchung möchte das Unternehmen womöglich, dass seine Ergebnisse mit seinem Namen verbunden werden.
Bevor Sie eine technische Einstellung ändern, würde ich diese Fragen klären:
- Welches geschäftliche Ziel soll die Seite unterstützen, und welchen Bedarf der Leser soll sie decken?
- Sind die Informationen allgemein oder an eine Marke, ein Produkt oder eine eigene Untersuchung gebunden?
- Wie wichtig sind eine Markennennung und ein Link zur Quelle in einer KI-Antwort?
- Welche Folgen können veraltete oder unvollständige Angaben haben?
- Lassen sich die Präferenzen für Training und Suche beim jeweiligen Anbieter tatsächlich getrennt verwalten?
Die passende Einstellung hängt von der Seite und dem Geschäftsziel ab. Ein Herausgeber kann die breitere Nutzung seines Wissens schätzen. Ein anderes Unternehmen sieht möglicherweise keinen messbaren Ertrag, wenn seine Inhalte ohne Quellenangabe genutzt werden. Ein Hersteller möchte, dass sein Produkt gefunden wird, und legt zugleich besonderen Wert auf korrekte, aktuelle Angaben.
OpenAIs Ankündigung hat diese Frage für mich sichtbar gemacht. Eine Präferenz in robots.txt wirkt wie eine technische Einstellung. Dahinter stehen jedoch Entscheidungen über Investitionen in Inhalte, deren Verbreitung und die Kontrolle darüber. Welche Nutzung wertvoll ist, lässt sich erst beurteilen, wenn klar ist, was der Inhalt für das Unternehmen und seine Leser leisten soll.
Wenn dieser Artikel hilfreich war
Ein Link von einer passenden Seite Ihrer Website oder das Teilen in sozialen Medien hilft diesem Artikel, mehr Menschen zu erreichen. Vielen Dank.
Hinweise zu Links und Marke →Über diesen Artikel
Dieser Beitrag wurde auf Grundlage der englischen Fassung redaktionell für die deutsche Ausgabe lokalisiert.
- Einsatz künstlicher Intelligenz
- Mit KI-Unterstützung — Idee und Ausrichtung dieses Beitrags stammen von Evren Bal. Recherche, Textentwurf und Übersetzung wurden mit KI-Werkzeugen unterstützt.
Ein kleines Experiment
Persönliche Messwerte werden geladen…