Verständnisschulden: Die Rechnung kommt, wenn man allein ist
Von Evren BalVeröffentlicht Aktualisiert · 8 Min. Lesezeit
Seite kopieren
Ich nutze KI-Coding-Agenten fast täglich. Das schreibe ich nicht als jemand, der Copilot einmal probiert und sich dann erschrocken zurückgezogen hat, sondern als Solo-Founder, der diese Werkzeuge ausreichend nutzt, um zu sehen, wo das eigentliche Risiko beginnt.
Code kompiliert oft, besteht Tests und sieht im Diff sauber aus. Gefährlich ist die Lücke zwischen dem, was das System inzwischen kann, und dem, was ich noch erklären, debuggen und sicher ändern kann.
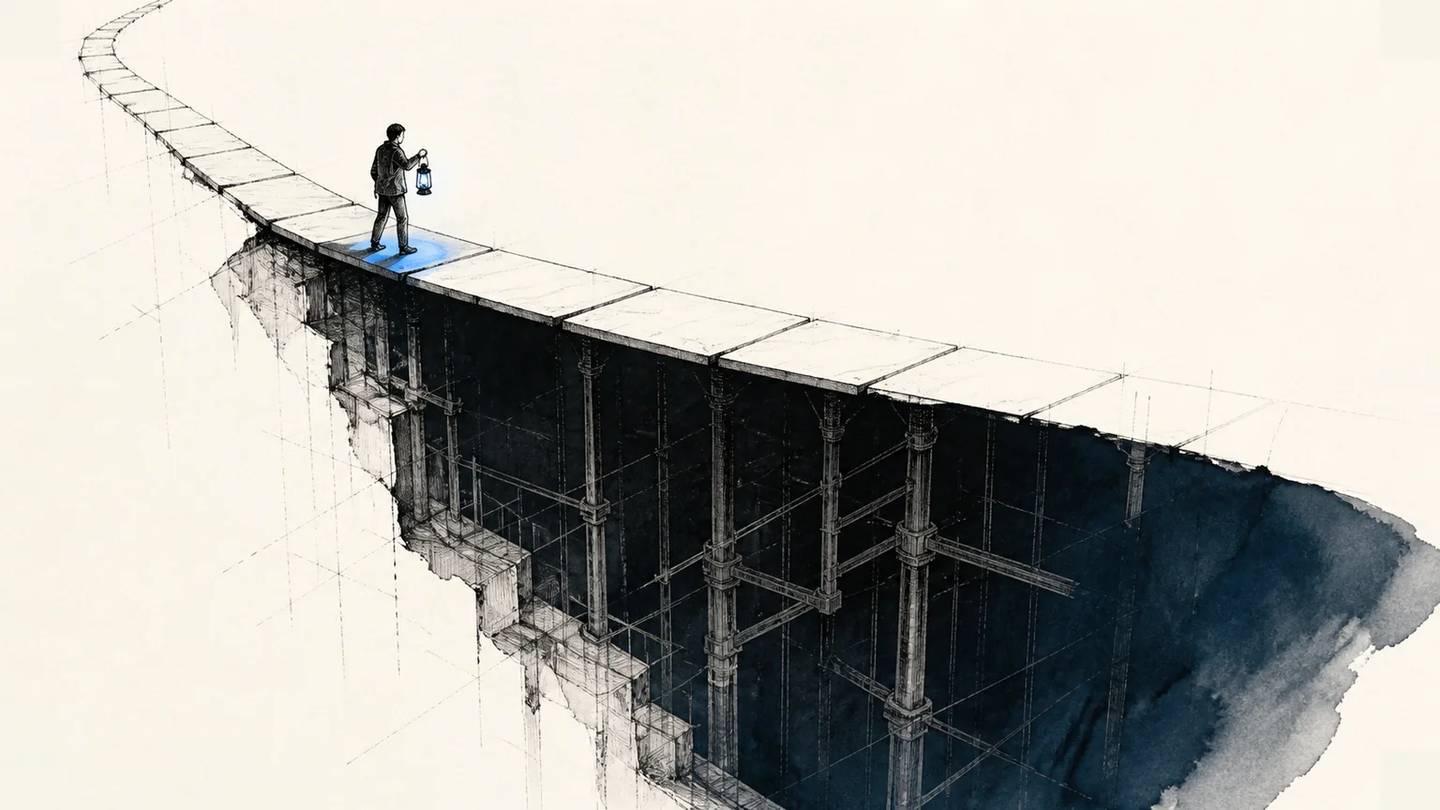
Diese Lücke nenne ich Verständnisschulden. Sie wachsen, wenn Code schneller ins System gelangt, als sich ein verlässliches mentales Modell darum bildet. In einem Solo-Projekt gibt es keinen unabhängigen Reviewer, der fehlenden Kontext automatisch aufnimmt. Ich bleibe für Geschwindigkeit und Verständnis verantwortlich.
Kurz:
- Verständnisschulden sind nicht dasselbe wie unordentlicher Code. Auch sauberer, getesteter Code kann schlecht verstanden sein.
- KI verursacht das Problem nicht allein. Es entsteht, wenn Änderungen angenommen werden, ohne die Begründung aufzubauen oder festzuhalten.
- Allein zu arbeiten beweist nicht, dass das Risiko immer größer ist als im Team; es entfernt aber die natürliche Chance eines zweiten unabhängigen mentalen Modells.
- Meine Reaktion: Absicht explizit machen, Änderungen klein halten, sie vor Annahme erklären und stoppen, wenn die Prüfung mein Verständnis übersteigt.
Schulden, die Codequalität nicht zeigt
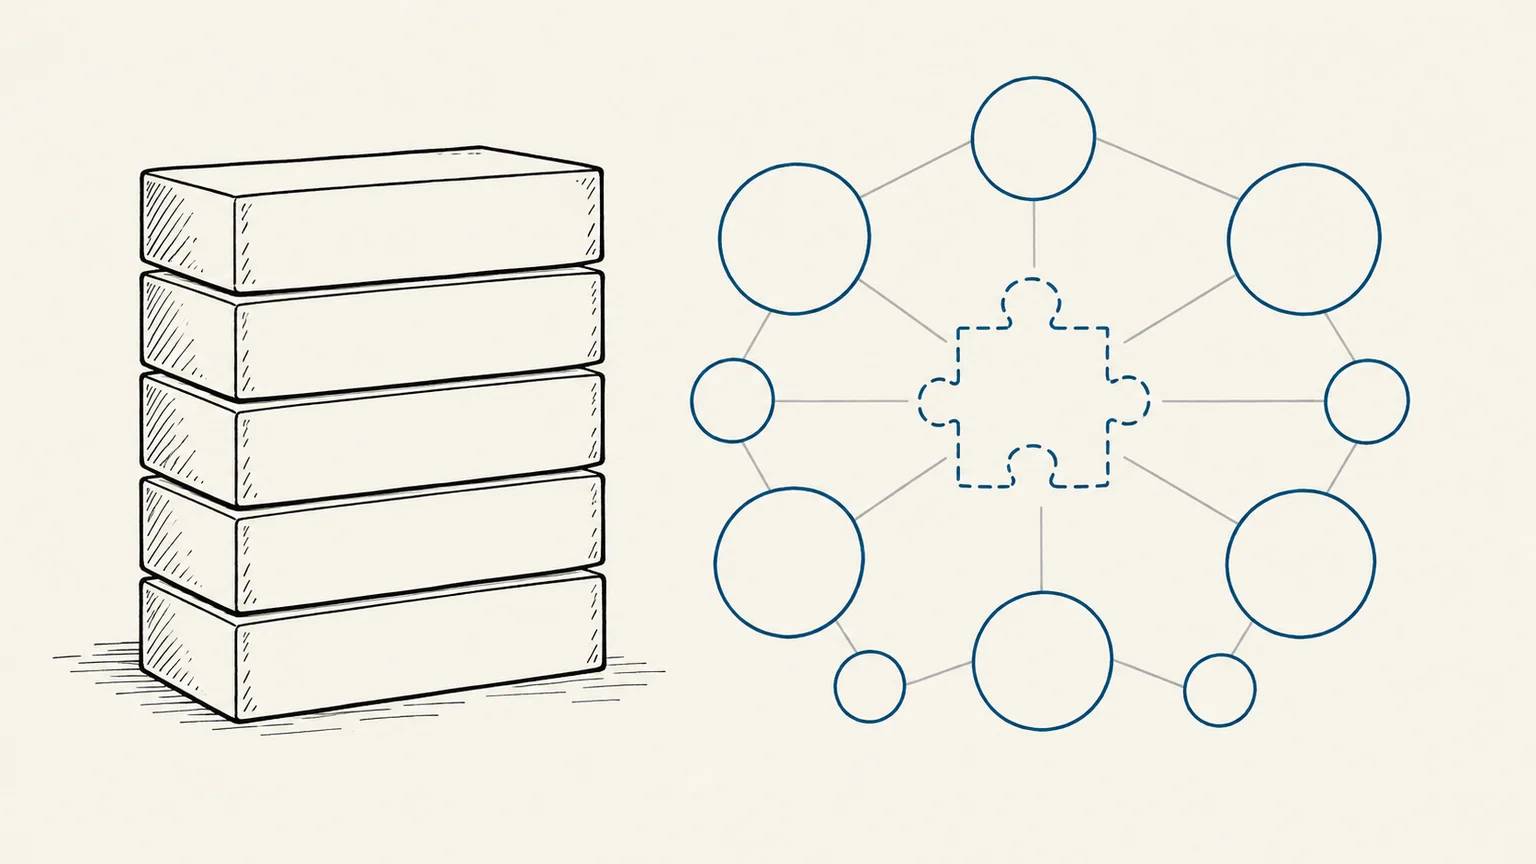
Technische Schulden liegen meist in Entwurfs- und Umsetzungsentscheidungen. Verständnisschulden liegen in der Diskrepanz zwischen dem, was ein System von seinem Maintainer verlangt, und dem, was dieser versteht. Beides kann zusammenfallen, ist aber nicht identisch.
Ein verwobenes Modul kann vertraut genug sein, um es sicher zu ändern. Ein poliertes Modul aus einer langen Agentensitzung kann alle Checks bestehen, ohne dass jemand seine Annahmen benennen kann. Kein Dashboard zeigt das. Die Kosten entstehen bei der nächsten Änderung, wenn Urteilskraft erforderlich wird, die nie aufgebaut oder dokumentiert wurde.
Warnzeichen sind: Ich muss den Agenten fragen, was eine frische Änderung macht; Tests bestehen, aber ich kann weder geschütztes Verhalten noch übersehene Fehlerwege benennen; eine kleine Änderung wirkt riskant, weil ich ihre Reichweite nicht kenne; die einzige Entscheidungsbegründung ist eine KI-Zusammenfassung; ich kann die Ausgabe, nicht aber ihren Ort und Grund im System erklären. Das bedeutet nicht automatisch falschen Code, aber schwächere Verantwortung als das Codevolumen vermuten lässt.
Was die Forschung zeigt – und was nicht
Die aktuelle Forschung liefert gute Gründe, das Risiko ernst zu nehmen. Ein allgemeines Urteil über KI-gestützte Softwareentwicklung lässt sich daraus jedoch nicht ableiten.
Sicherheit. Der Veracode GenAI Code Security Report 2025 bewertete mehr als 100 Modelle in über 80 Coding-Aufgaben und meldete bei 45 % der Tests eine bekannte Sicherheitslücke.
Diese Zahl beschreibt generierte Lösungen in einer klar abgegrenzten Untersuchung. Sie bedeutet nicht, dass 45 % aller produktiven Änderungen mit KI verwundbar sind. Der Befund spricht für sorgfältige Prüfung bei Änderungen mit hohem Risiko, aber nicht dafür, jede KI-Ergänzung als gefährlich zu behandeln.
Hinweise auf Wartbarkeit. GitClear analysierte 211 Millionen geänderte Zeilen von 2020 bis 2024. Der Anteil kopierter Zeilen stieg demnach von 8,3 % auf 12,3 %, während der Anteil der mit Refactoring verbundenen Änderungen von 25 % auf unter 10 % fiel.
Das ist ein breiter Beobachtungstrend über viele Repositories und mehrere Jahre. Daraus lässt sich KI nicht als Ursache für jede einzelne Änderung ableiten. Ebenso wenig erlaubt der Trend eine sichere Aussage über ein bestimmtes Repository.
Lernen und unmittelbares Verständnis. In Anthropics randomisierter Studie lernten 52 überwiegend Junior-Entwickler eine unbekannte Python-Bibliothek. Die KI-unterstützte Gruppe erreichte in einem Quiz unmittelbar nach der Aufgabe durchschnittlich 50 %, die Gruppe, die ohne KI programmierte, 67 %. Wer die KI für konzeptionelle Fragen oder Erklärungen nutzte, schnitt tendenziell besser ab als Personen, die ihr die Arbeit überließen.
Der Zusammenhang zwischen diesen Nutzungsmustern und den Ergebnissen ist eine qualitative Beobachtung, kein Kausalbeleg. Die Studie beantwortet weder die Frage nach langfristigem Lernen noch nach heutigen agentischen Arbeitsabläufen.
Produktivität hängt von Kontext und Zeitpunkt ab. In METRs randomisierter Studie von Anfang 2025 brauchten 16 erfahrene Open-Source-Entwickler in vertrauten Repositories mit den damals verfügbaren KI-Werkzeugen 19 % länger. Trotzdem glaubten sie, schneller zu sein.
METR beschreibt das Ergebnis als Momentaufnahme eines bestimmten Zeitraums, nicht als Urteil über Softwareentwicklung insgesamt. Das Update vom Februar 2026 hält die neueren Daten wegen der Auswahl von Teilnehmenden und Aufgaben für ungeeignet, um daraus eine verlässliche aktuelle Schätzung abzuleiten. Zugleich hält METR es für wahrscheinlich, dass neuere Werkzeuge größere Zeitgewinne ermöglichen als die frühe Studie gemessen hat.
Ein separater Preprint zur Einführung von Copilot fand, dass sich die Produktivitätsgewinne in den untersuchten Open-Source-Projekten auf weniger erfahrene Mitwirkende konzentrierten. Nach der Einführung prüften Kernentwickler 6,5 % mehr Code und produzierten 19 % weniger eigenen Code.
Dieses Ergebnis gilt für die untersuchten Projekte und die verwendete Methode. Es zeigt nicht, dass sich die Arbeit aller erfahrenen Entwickler auf dieselbe Weise verändert.
Gemeinsam stützen diese Studien eine engere Schlussfolgerung: Generationsgeschwindigkeit, Codequalität, Lernen und die Kapazität, Änderungen zu prüfen, bewegen sich nicht automatisch gemeinsam. Der Arbeitsablauf entscheidet, wo die Kosten entstehen.
Warum Alleinarbeit die Gefahr verändert
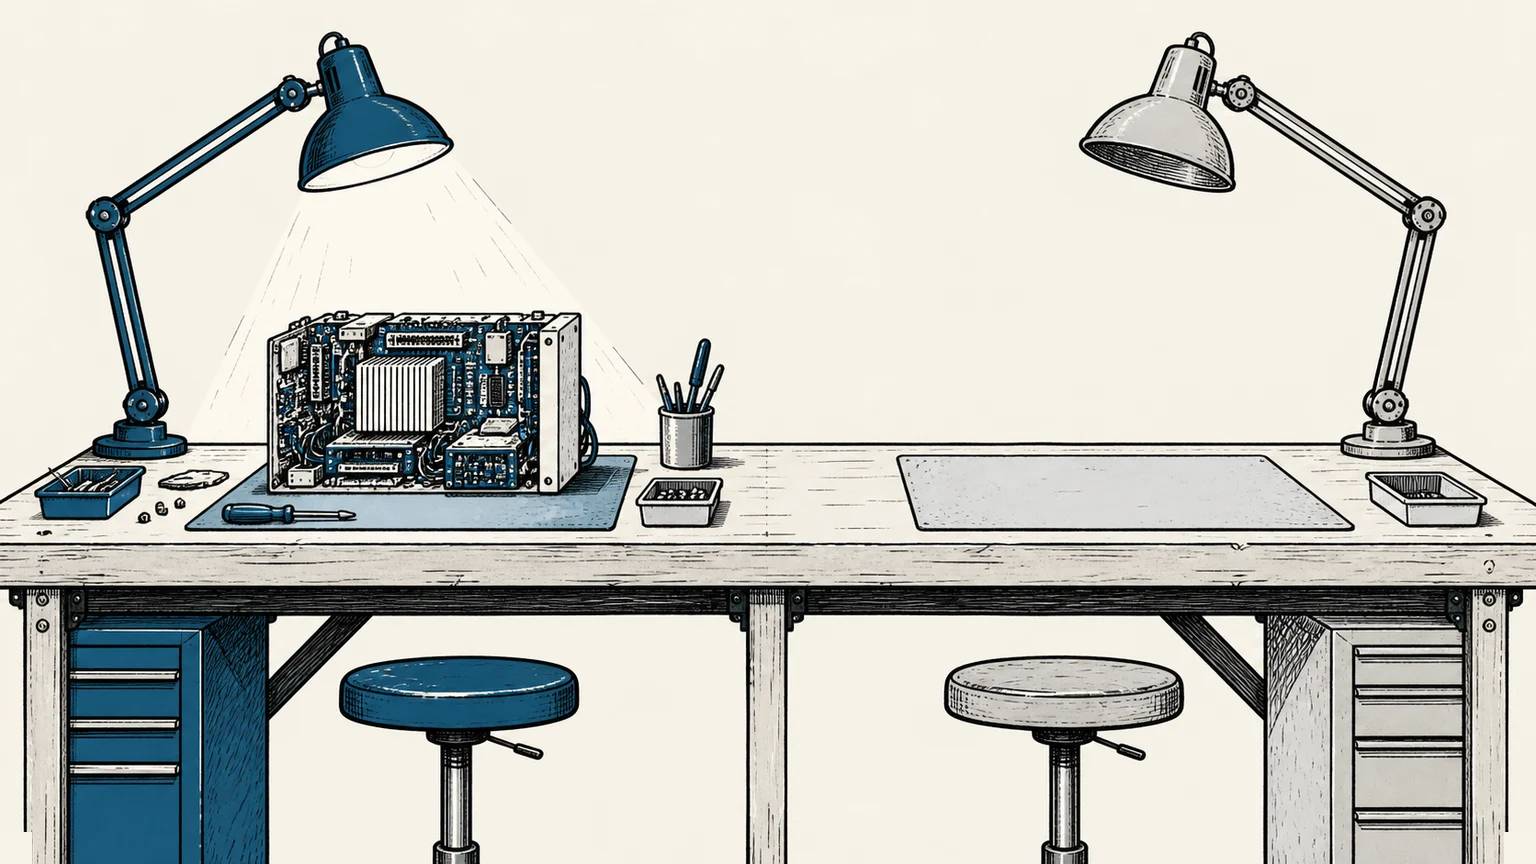
Teams können Verständnis durch Entwurfsdiskussion, Review, Pairing und Incident Response verteilen. Das garantiert nichts, schafft aber Chancen, Annahmen anzufechten oder Kontext unabhängig zu behalten. Wer allein arbeitet, nimmt den Vorschlag an und muss ihn zugleich hinterfragen. Nach einer schnellen Stunde mit einem Agenten muss ich mit frischen Augen zurückkehren; niemand anders kann den übersehenen Shortcut sehen.
Das beweist nicht mehr Schulden als in jedem Team. Im Team kann fehlendes Verständnis verteilt oder verborgen sein; allein summiert es sich an einer Stelle. Wenn ich ein System im Produktionsvorfall nicht erklären kann, gibt es kein anderes mentales Modell im Raum. Das unterscheidet sich vom Team-Engpass in KI hat Code billig gemacht. Prüfung ist weiterhin teuer: Dort ist die Frage, ob ein Team wachsende Ausgabe prüfen kann; hier, ob der letztlich Verantwortliche sie noch versteht.
Wie ich die Werkzeuge weiter nutze
Ich will nicht weniger KI verwenden, sondern Arbeit innerhalb der Grenze halten, die ich verantworten kann.
Absicht und Akzeptanzkriterien zuerst. Vor einer Änderung formuliere ich Problem, Einschränkungen und unverändertes Verhalten in klarer Sprache. Code bleibt Umsetzung und muss lesbar sein, darf aber nicht der einzige erhaltene Entscheidungsnachweis sein. Kann ich Erfolg vor der Generierung nicht benennen, schafft eine bestehende Testsuite diese Klarheit nicht nachträglich.
Änderungen kleiner als mein Verständnisfenster. Große autonome Läufe können mehrere Architekturgrenzen überqueren, bevor die erste falsche Annahme sichtbar wird. Kleine Änderungen erlauben es, Begründung zu prüfen, Verhalten zu testen und zurückzugehen. Meine Stoppregel: Kann ich die aktuelle Änderung ohne Rekonstruktion durch den Agenten nicht mehr erklären, ist sie zu groß oder ich war zu schnell.
KI für Untersuchung, nicht nur Delegation. Ich bitte um Optionen, Annahmen, Erklärungen unbekannter Pfade und Gegenprüfung meines Verständnisses. Vor Annahme formuliere ich die Entscheidung selbst. Eine KI-Erklärung kann ein mentales Modell aufbauen, beweist aber nicht, dass ich eines habe.
Risikoreiches gilt bis zur Prüfung als nicht vertrauenswürdig. Authentifizierung, Autorisierung, Zahlungen, Nutzerdaten und Systemgrenzen brauchen einen skeptischeren Weg: Implementierung prüfen, Tests aus Anforderung statt aus generiertem Code ableiten, statische und Sicherheitschecks ausführen und Beobachtbarkeit sowie Umkehrbarkeit sicherstellen. Ein zweites Modell kann Signal liefern, aber keine unabhängige Verantwortlichkeit schaffen.
Typen als eine Leitplanke. Eine Studie zu typbeschränkter Codegenerierung fand in ihrem TypeScript-Benchmark, dass 94 % der Kompilierfehler aus fehlgeschlagenen Typchecks resultierten. Das vorgeschlagene Decodierverfahren reduzierte die Zahl der Kompilierfehler um mehr als die Hälfte. Das gilt in diesem Benchmark, nicht für 94 % aller KI-Fehler. Typen verhindern mechanisch ungültige Zustände, beweisen aber weder richtige Anforderungen noch passende Autorisierung oder Geschäftsverhalten.
Mehrschichtige Prüfung und Stopp. Tests, Typchecks, Linter, Abhängigkeitschecks, Sicherheitsanalyse, Logs und Rollback-Pfade fangen verschiedene Fehler ab. Die Kombination ist stärker als ein einzelner Check, auch stärker als müdes eigenes Urteil. Die letzte Schranke bleibt Verständnis: Wenn Checks bestehen, ich die Änderung, die Annahmen und wahrscheinliche Fehlerwege aber nicht erklären kann, ist sie nicht bereit. Automatisierung soll Skepsis wiederholbar machen, nicht Verantwortung verschwinden lassen.
Strenge Open-Source-Regeln sind keine Evidenz für ein universelles Verbot. Zig verbietet LLM-generierte Inhalte in geregelten Community-Räumen; NetBSD betrachtet LLM-Code ohne vorherige schriftliche Core-Genehmigung als belastet; QEMU lehnt KI-generierte Beiträge derzeit wegen Herkunft, Urheberrecht, Lizenzierung und Developer Certificate of Origin ab. Das zeigt: Verantwortliche Softwarearbeit umfasst auch Herkunft, geltende Regeln und die Person, die dafür einstehen kann.
Die Rechnung wird fällig, wenn das System sich ändern muss. Ein besseres Modell kann unbekannten Code erklären oder refaktorieren; aus der Umsetzung allein lässt sich die nicht dokumentierte Absicht aber nicht zuverlässig rekonstruieren: Warum eine Grenze wichtig war, welche Alternative verworfen wurde, welches Kundenverhalten die Entscheidung prägte, welchen Zielkonflikt das System bewahren sollte. Fehlt diese Begründung außerhalb eines flüchtigen Gesprächs, legt ein weiterer Agent womöglich nur neue Annahmen auf alte.
Die knappe Fähigkeit ist nicht mehr, jede Zeile von Hand zu schreiben, sondern für Ausgeliefertes einzustehen: warum es existiert, was es schützt, wie es geprüft wurde und wann es falsch liegt. Für einen Solo-Founder ist das keine optionale Politur. Es ist die Aufgabe. Geschwindigkeit ohne Verständnis ist keine kostenlose Produktivität; sie ist ein Kredit, dessen Rechnung niemand anders erhält.
Wenn dieser Artikel hilfreich war
Ein Link von einer passenden Seite Ihrer Website oder das Teilen in sozialen Medien hilft diesem Artikel, mehr Menschen zu erreichen. Vielen Dank.
Hinweise zu Links und Marke →Über diesen Artikel
Dieser Beitrag wurde auf Grundlage der englischen Fassung redaktionell für die deutsche Ausgabe lokalisiert.
Ein kleines Experiment
Persönliche Messwerte werden geladen…