Was eine KI-Kennzeichnung über den Beitrag des Autors aussagt
Von Evren BalVeröffentlicht · 7 Min. Lesezeit
Seite kopieren
Stellen Sie sich vor, neben einem Artikel steht der Hinweis: „Mit Unterstützung von KI erstellt.“ Hat die KI nur den Text des Autors sprachlich überarbeitet? Hat sie aus seinen Notizen einen ersten Entwurf erstellt? Oder hat das Modell auch Thema, Beispiele und Schlussfolgerung weitgehend bestimmt?
Sie haben den Hinweis gelesen und wissen trotzdem nicht, wie der Text entstanden ist.
Auch ich nutze KI beim Schreiben meiner Artikel und lege das offen. Ich habe jedoch keine Messung dazu, wie sich diese Hinweise auf das Vertrauen meiner Leser auswirken.
Untersuchen lässt sich dennoch, was die Kennzeichnung selbst vermittelt. Mit dem Satz „Ich habe KI verwendet“ informiere ich darüber, dass ein Werkzeug zum Einsatz kam. Leser interessiert möglicherweise stärker, welchen Beitrag dieses Werkzeug zur Entstehung des Gedankens und des Textes geleistet hat.
Derselbe Hinweis kann sehr unterschiedliche Schreibprozesse beschreiben
Ein Autor entwickelt den Kerngedanken, wählt die Beispiele aus und schreibt den Artikel. Anschließend lässt er eine KI lange Sätze vereinfachen. Ein anderer Autor hält seine Sicht, seine Erfahrung und seine Quellen in Arbeitsnotizen fest und lässt ein Modell den ersten Entwurf erstellen. Anschließend überarbeitet er diesen Entwurf.
In beiden Fällen leistet der Mensch einen Beitrag, aber an einer anderen Stelle. Im ersten Fall verändert die KI die sprachliche Form eines bestehenden Textes. Im zweiten erstellt sie auch den ersten Entwurf. Der Hinweis „mit Unterstützung von KI“ erklärt diesen Unterschied allein nicht.
In meiner KI-Nutzungsrichtlinie unterscheide ich zwischen sprachlicher Überarbeitung und umfangreicherer Unterstützung beim Entwurf. Eine allgemeine Richtlinie kann jedoch nicht immer erklären, was bei jedem einzelnen Artikel geschehen ist. In einem Text kann sich die Unterstützung auf die Recherche beschränken. In einem anderen erstellt das Modell möglicherweise einen erheblichen Teil des ersten Entwurfs.
Der Unterschied lässt sich auch nicht allein daran ablesen, wer wie viele Wörter geschrieben hat. Ein Mensch kann den größten Teil eines Artikels verfassen und trotzdem die zentrale Behauptung ungeprüft von einem Modell übernehmen. Umgekehrt kann eine detaillierte, aus eigener Erfahrung entwickelte Argumentation mithilfe eines Modells zu einem besser lesbaren Text werden. Die Wortzahl zeigt nicht, woher der Gedanke stammt.
Bleibt die Kennzeichnung vage, füllen Leser die Lücke selbst
Eine 2024 in PNAS Nexus veröffentlichte Studie von Sacha Altay und Fabrizio Gilardi zu KI-Kennzeichnungen bei Nachrichtenüberschriften untersuchte diese Unklarheit in einem kontrollierten Experiment. Teilnehmende aus den USA und dem Vereinigten Königreich bewerteten online präsentierte Nachrichtenüberschriften, die als Beiträge in sozialen Medien dargestellt wurden.
Im zweiten Experiment blieb die Kennzeichnung „Text wurde durch künstliche Intelligenz generiert“ unverändert. Die Forschenden erklärten ihre Bedeutung anhand verschiedener Arbeitsteilungen. Einer Gruppe wurde gesagt, ein Journalist habe das Thema gewählt und den Artikel geschrieben, während die KI Sprache und Stil überarbeitet habe. Eine andere Gruppe erfuhr, der Journalist habe Thema und Quellen bereitgestellt und die KI den ersten Entwurf verfasst. In einer dritten Variante wählte die KI das Thema und erstellte den gesamten Artikel. Eine weitere Gruppe sah die Kennzeichnung ohne Erklärung.
Die Forschenden werteten aus, wie zutreffend die Teilnehmenden die Überschriften fanden und wie wahrscheinlich sie diese teilen würden. Erklärungen zur sprachlichen Überarbeitung und zur Erstellung eines ersten Entwurfs aus bereitgestellten Quellen führten zu positiveren Ergebnissen als die Kennzeichnung ohne Erklärung. Die Bewertungen dieser beiden Gruppen waren nicht signifikant höher als die der Kontrollgruppe ohne Kennzeichnung.
Der Unterschied lag also in der Arbeitsteilung, die den Teilnehmenden beschrieben wurde. Außerdem erhielten sie die Erklärungen vorab, ihr Verständnis wurde geprüft und die Erklärung wiederholt. Das Experiment zeigt deshalb nicht, dass ein etwas längerer Hinweis auf einer Webseite immer zu besseren Ergebnissen führt. Gemessen wurden weder die tatsächliche Richtigkeit der Nachrichten noch, ob die Teilnehmenden sie wirklich teilten, sondern unmittelbare Bewertungen der Überschriften.
Ich ziehe daraus einen engeren Schluss: Bevor wir vorhersagen, wie Leser reagieren, müssen wir klären, welchen Schreibprozess wir ihnen beschreiben.
Leser können von einem Autor mehr als korrekte Informationen erwarten
Nehmen wir an, eine Führungskraft liest, wie eine andere Führungskraft eine schwierige Entscheidung schildert. Der Leser sucht vielleicht nach richtigen Informationen. Zugleich möchte er womöglich verstehen, welche Option diese Person aus welchem Grund verworfen hat, was sie falsch eingeschätzt hat und wie sie mit dem Ergebnis umgegangen ist.
Für diese Erwartung spielt Erfahrung aus erster Hand eine Rolle. „Ich habe diese Entscheidung getroffen“ verspricht etwas anderes als „In einer solchen Situation könnte man diese Entscheidung treffen“. Die zweite Formulierung kann eine nützliche Analyse einleiten. Die erste kann sie aber nur ersetzen, wenn die geschilderte Erfahrung tatsächlich gemacht wurde.
Wer jeden Leser mit Interesse am KI-Einsatz von vornherein für voreingenommen hält, übersieht diesen Unterschied. Ein Leser kann die Richtigkeit der Informationen hinterfragen und zugleich wissen wollen, was der Autor beigetragen hat. Ob ein Gedanke vom Autor entwickelt, von jemand anderem übernommen oder aus einem Modellvorschlag weiterentwickelt wurde, kann dafür wichtig sein, warum der Leser Zeit in den Artikel investiert.
Die Forschung hat dies nicht für alle Leser nachgewiesen. Es ist eine Erwartung, die ich im Verhältnis zwischen Autor und Leser für angemessen halte. Lesern zu sagen: „Wenn die Information stimmt, warum sollte ihre Entstehung eine Rolle spielen?“, würde ihnen vorschreiben, was sie wertschätzen dürfen.
In meinem früheren Artikel darüber, warum wir KI-Urteilen vertrauen, habe ich zwischen der Annahme einer Empfehlung und einer guten Entscheidung unterschieden. Hier geht es darum, welchen Beitrag Leser von der Person erwarten, deren Name über dem Artikel steht. Ein Text kann richtige Informationen enthalten und diese Erwartung dennoch nicht erfüllen.
Eine hilfreiche Kennzeichnung macht die Arbeitsteilung sichtbar
Die Verantwortung für einen Artikel zu übernehmen beschreibt nicht die gesamte Arbeit an seiner Entstehung. Einen Text freizugeben und seinen ersten Entwurf zu schreiben sind unterschiedliche Beiträge. Das gilt auch für die Suche nach einer Quelle und die Entscheidung darüber, welche Schlussfolgerung sich aus ihr ziehen lässt.
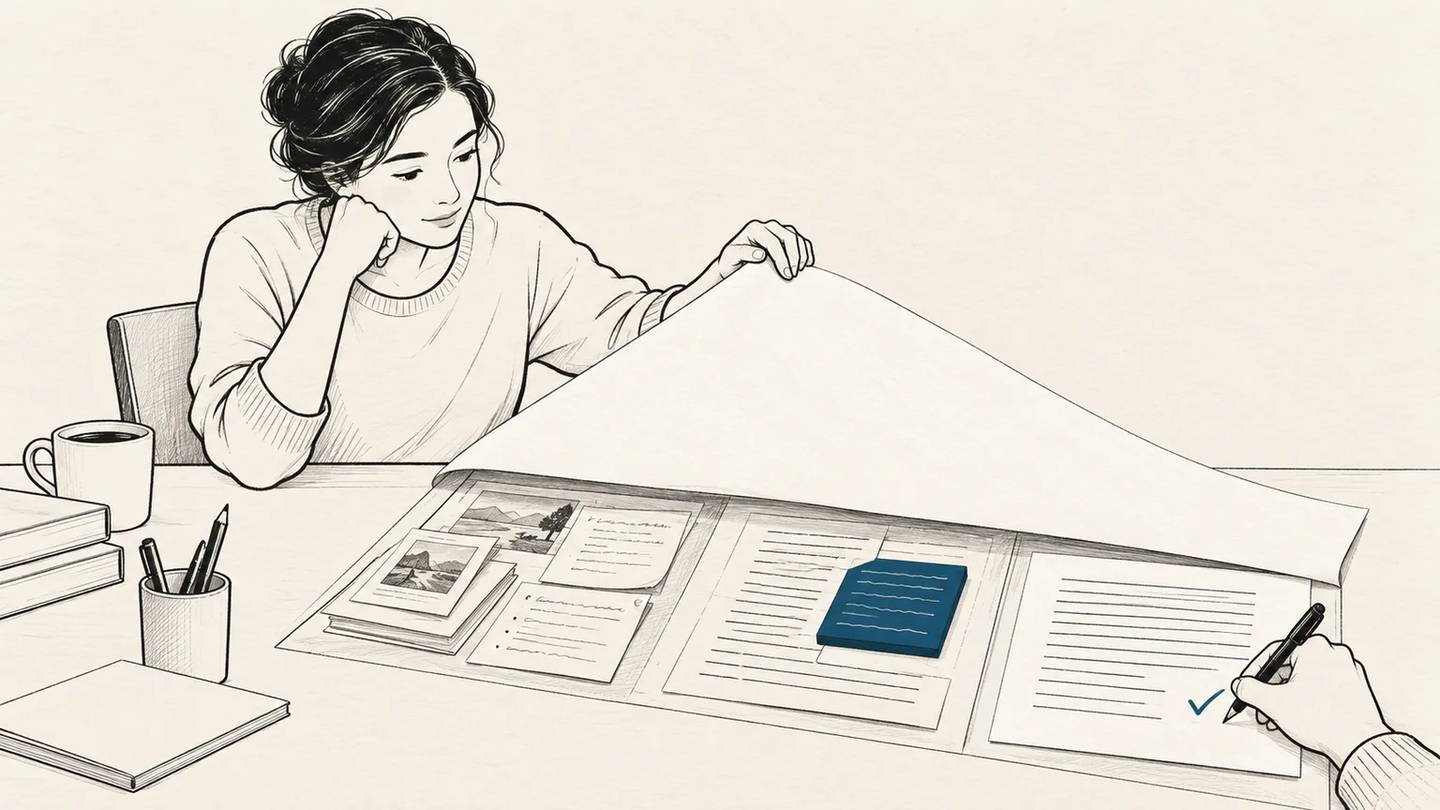
Ein Hinweis zur KI-Nutzung kann deshalb hilfreicher sein, wenn er den wesentlichen Beitrag des Modells beschreibt, statt nur seinen Namen oder die Zahl seiner Einsätze zu nennen. Welches Material lieferte der Autor? Welchen Teil bereitete die KI vor? Was untersuchte und veränderte der Autor anschließend?
Zwei hypothetische Hinweise machen den Unterschied sichtbar. Sie dokumentieren nicht, wie sämtliche Artikel auf dieser Website entstanden sind:
Der vom Autor verfasste Text wurde mithilfe von KI sprachlich vereinfacht und korrigiert. Der Autor hat den endgültigen Text geprüft.
Der erste Entwurf entstand mithilfe von KI aus den Ansichten, Erfahrungsnotizen und Quellen des Autors. Der Autor prüfte, ob die Quellen die jeweiligen Aussagen stützen, überarbeitete den Text und gab die endgültige Fassung frei.
Wenn die Prüfungen im zweiten Hinweis tatsächlich nicht stattgefunden haben, dürfen diese Sätze nicht verwendet werden. Eine ausführlichere Kennzeichnung kann auch nur eine ausführlichere Behauptung sein. Ihr Wert entsteht erst, wenn sie der geleisteten Arbeit entspricht.
In meinem Experiment mit Open Publishing und monatlichen KI-gestützten SEO-Berichten beschreibe ich den Arbeitsprozess hinter den KI-gestützten Auswertungen gesondert. Ein Bericht und ein persönlicher Erfahrungsbericht brauchen möglicherweise nicht dieselbe Kennzeichnung. Diese Unterscheidung soll zeigen, wie der Text tatsächlich entstanden ist. Sie dient nicht dazu, den Prozess menschlicher oder automatisierter erscheinen zu lassen, als er war.
Eine Kennzeichnung soll informieren, nicht überzeugen
Ich würde den Erfolg einer KI-Kennzeichnung nicht daran messen, ob jeder Leser den Artikel danach gleich gut findet. Ein klarerer Hinweis kann manche Leser beruhigen. Andere können entscheiden, dass die beschriebene Form des Beitrags nicht dem entspricht, was sie gesucht haben. Welche Reaktion bei meinen eigenen Lesern überwiegt, habe ich nicht gemessen.
Die Kennzeichnung sollte genügend Informationen für diese Entscheidung liefern. Wenn ich KI zur sprachlichen Überarbeitung genutzt habe, sollte sie das sagen. Hat ein Modell den ersten Entwurf erstellt, sollte sie stattdessen diesen Beitrag nennen. Wenn eine menschliche Prüfung stattgefunden hat, sollte der Hinweis erklären, was geprüft wurde. Eine Prüfung, die nicht stattgefunden hat, darf er nicht vortäuschen.
Der Name über einem Artikel sagt Lesern, mit wem sie es zu tun haben. Die Kennzeichnung kann ihnen helfen zu verstehen, wie diese Person zum Text beigetragen hat. Darin liegt der Wert des Wechsels von „Ich habe KI verwendet“ zu „Das hat die KI in diesem Artikel übernommen, und dazu habe ich beigetragen.“
Wenn dieser Artikel hilfreich war
Ein Link von einer passenden Seite Ihrer Website oder das Teilen in sozialen Medien hilft diesem Artikel, mehr Menschen zu erreichen. Vielen Dank.
Hinweise zu Links und Marke →Über diesen Artikel
Dieser Beitrag wurde auf Grundlage der englischen Fassung redaktionell für die deutsche Ausgabe lokalisiert.
- Einsatz künstlicher Intelligenz
- Mit KI-Unterstützung — Evren Bal bestimmte das Thema, den persönlichen Kontext und die beabsichtigte Argumentation. KI unterstützte die Quellenprüfung, Forschungssynthese, den ersten türkischen Entwurf sowie die englische und deutsche Fassung.
Ein kleines Experiment
Persönliche Messwerte werden geladen…