Bilden Tests zur KI-Sichtbarkeit echte Kunden ab?
Von Evren BalVeröffentlicht · 7 Min. Lesezeit
Seite kopieren
💡 Kurzfassung (TL;DR):
- Wiederholte Durchläufe desselben Tests können eine berechnete Rate weniger anfällig für Zufallsschwankungen machen. Sie beweisen nicht, dass das Ergebnis tatsächliches Kundenverhalten abbildet.
- Unabhängige Fragen lassen sowohl den Verlauf eines Gesprächs als auch den darin aufgebauten Kontext aus. Eine Marke, die in der ersten Antwort fehlt, kann später passend werden.
- Kontrollierte Tests sind nützlich. Um ihre Ergebnisse auf Kundengespräche zu übertragen, braucht es einen nachgewiesenen Zusammenhang zwischen Testbedingungen und Kundenverhalten.
Angenommen, ein Marketingteam erhält einen Bericht, nach dem die KI-Empfehlungsrate seiner Marke von 37 % auf 43 % gestiegen ist. Die Fragen wurden wiederholt gestellt, die Ergebnisse gemittelt. Im Diagramm ist der Anstieg klar zu sehen.
Für die Fragen und Bedingungen dieses Tests kann das ein aussagekräftiger Befund sein. Damit ist aber noch nicht gezeigt, dass derselbe Anstieg in Gesprächen auftritt, in denen Kunden KI um Empfehlungen bitten. Wie gut bilden die ausgewählten Fragen die Bedürfnisse der Kunden ab? Beschreibt das Ergebnis eine erste Antwort oder ein fortlaufendes Gespräch?
In einem früheren Beitrag darüber, was Tools zur KI-Sichtbarkeit tatsächlich messen, habe ich den Unterschied zwischen Prompt-Tests und Nutzererfahrung betrachtet. Hier geht es nicht nur darum, wie präzise eine gemessene Veränderung ist, sondern auch darum, für welche Situationen das Ergebnis gilt.
Was verbessert die Wiederholung desselben Tests?
Ein Ansatz zur Messung von KI-Sichtbarkeit beginnt mit einer Liste von Fragen oder Prompts, die an ein KI-System gesendet werden. Die Antworten werden erfasst, das Auftauchen der Marke wird identifiziert und die Ergebnisse zusammengeführt. Manche Dienste überwachen Fragen, die Kunden ausgewählt haben; andere ziehen Stichproben aus breiteren Datenbanken.
Ein KI-System kann auf dieselbe Frage unterschiedlich antworten. Bleiben die Bedingungen stabil und sind die Durchläufe ausreichend unabhängig, kann die Wiederholung eines Tests den Einfluss zufälliger Schwankungen auf die berechnete Rate verringern. Die Messung wird präziser.
Validität betrifft etwas anderes: wie gut diese Rate tatsächliches Kundenverhalten abbildet. Dieselbe Frage tausendmal zu stellen, liefert keine Informationen über Fragen und Gespräche, die im Test fehlen. Die Wiederholung bleibt innerhalb der bereits ausgewählten Fragen, Einstellungen und Märkte.
Das Vertrauen in die Rate unter den eigenen Testbedingungen kann dadurch wachsen. Wie häufig diese Bedingungen bei tatsächlichen Kunden vorkommen, ist eine andere Frage.
Eine plausible Frage muss nicht repräsentativ sein
„Welche Spülmaschine ist die beste?“ ist eine vollkommen plausible Kundenfrage. Ein Marketer, Berater oder Sprachmodell kann Hunderte solcher Fragen erzeugen. Plausibilität zeigt nicht, welche Kunden diese Fragen stellen oder wie häufig sie das tun.
In einem schwachen Test können Fragen auf Annahmen eines Teams beruhen, aus SEO-Schlüsselwörtern zu Fragen umformuliert sein oder aus einer KI-generierten Liste stammen. Die Liste kann viele Aspekte eines Themas abdecken und dennoch eine Kundengruppe abbilden, für deren Existenz es keine Belege gibt.
Auch die Herkunft von Verhaltensdaten zählt. In Suchmaschinen gestellte Fragen zeigen Suchverhalten. Bevor dieselben Daten als repräsentativ für KI-Gespräche gelten können, braucht es gesonderte Belege. Selbst ein Prompt-Pool aus realer Nutzung braucht eine klare Abdeckung: Welche Länder, Sprachen und Kundengruppen sind enthalten, welche fehlen?
Anbieter arbeiten nicht alle nach denselben Methoden. Semrush nennt Daten zum Klickverhalten in der KI-Suche und Google-Keyword-Daten als Eingaben und beschreibt seine Kennzahlen als zur Orientierung gedacht. Das sind Aussagen des Anbieters, keine unabhängige Validierung. Sie zeigen aber, warum es falsch wäre anzunehmen, jedes Produkt stütze sich allein auf am Schreibtisch formulierte Fragen.
Belege aus den eigenen Kundeninteraktionen eines Unternehmens und aus beobachtetem Verhalten können einen stärkeren Ausgangspunkt bieten. Was man aus einer Kundengruppe ableiten kann, gilt jedoch nicht automatisch für eine andere. Datenmenge und die Menschen, die sie repräsentieren, sind getrennt zu betrachten.
Optionen verändern sich im Gesprächsverlauf
Für Suchrankings gibt es eine vertraute Messform: eine Suchanfrage, eine Ergebnisseite und eine Position. Ein Gespräch mit KI funktioniert anders, weil eine Antwort die nächste Frage verändern kann.
Ein hypothetischer Test könnte in neuen Gesprächen wiederholt fragen: „Welche Spülmaschine ist die beste?“, und die Marken in der ersten Antwort zählen. Ein tatsächlicher Kunde könnte stattdessen beginnen: „Können Sie mir helfen, eine Spülmaschine auszuwählen?“
Der Assistent fragt, wie viele Personen im Haushalt leben und wie viel Platz zur Verfügung steht. Der Kunde erklärt, dass die Küche zum Wohnbereich offen ist und deshalb die Lautstärke wichtig ist. Danach folgt das Budget. Nach einer schlechten Erfahrung mit dem vorherigen Gerät werden Reparaturkosten und der Service vor Ort relevant. Energieverbrauch und die Frage, ob das Gerät in die Küche passt, engen die Auswahl weiter ein.
Die für den Kauf entscheidende Empfehlung kann im fünften oder achten Gesprächsschritt auftauchen. Eine Marke, die in der ersten Antwort fehlt, kann später ein passender Kandidat werden. Eine anfangs vorgeschlagene Marke kann ausscheiden. Spricht der Assistent die Reparierbarkeit an, kann er den Kunden zudem zu einem Vergleich führen, den dieser zuvor nicht erwogen hatte.
Unabhängige Fragen zu Budget, Lautstärke und Zuverlässigkeit erfassen diese Abfolge nicht und auch nicht, wie die Fragen einander beeinflussen. Nach Zuverlässigkeit zu fragen, nachdem Budget und Lautstärke die Optionen bereits eingegrenzt haben, ist etwas anderes als in einem neuen Gespräch nach zuverlässigen Marken zu fragen.
Manche Kunden lösen ihr Anliegen in einem einzigen Austausch. Ein Test mit einem Gesprächsschritt kann diese Situation untersuchen. Soll sein Ergebnis auf ein längeres Kaufgespräch übertragen werden, muss gezeigt werden, dass der ausgelassene Gesprächsverlauf das Ergebnis nicht wesentlich verändert.
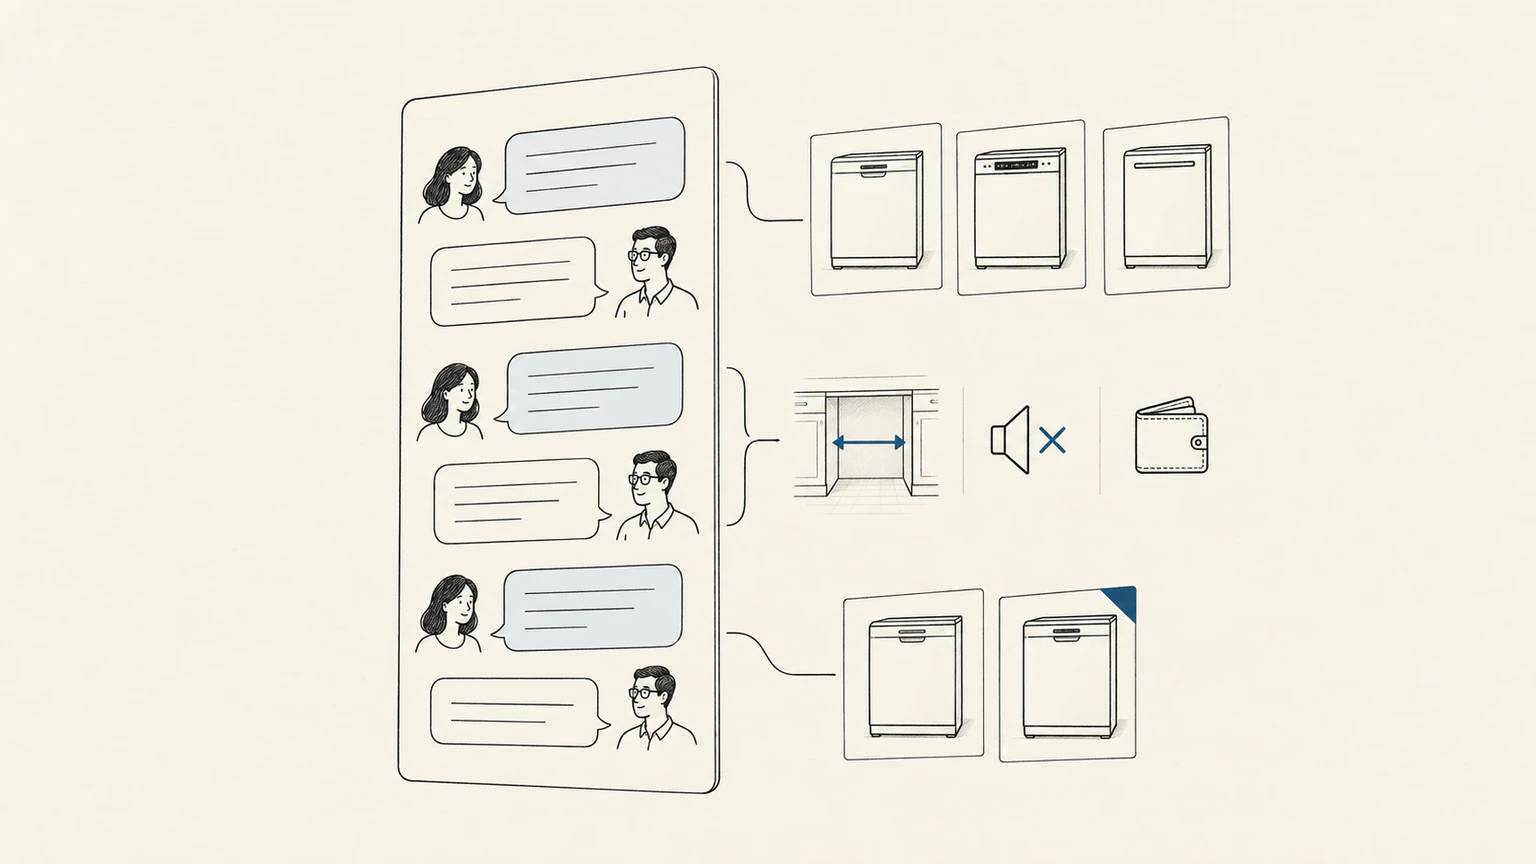
Hypothetisches Beispiel: Bedürfnisse und Bedingungen, die später im Gespräch hinzukommen, können die in Frage kommenden Produkte verändern. Die Illustration zeigt nicht das Ergebnis eines abgeschlossenen Experiments.
Ein leeres Gespräch bildet nicht die Bedingungen aller Nutzer ab
Je nach Produkt und Einstellungen können frühere Nachrichten, Nutzeranweisungen, gespeicherte Präferenzen oder frühere Gespräche Antworten beeinflussen. Sprache, Land, Modellversion und die Nutzung der Websuche gehören ebenfalls zu den Testbedingungen.
In den FAQ zur Memory-Funktion erklärt OpenAI, dass bei aktivierter Funktion Informationen aus früheren Interaktionen und anderen Quellen zur Personalisierung genutzt werden können. Das heißt nicht, dass für jeden Nutzer dieselben Informationen aktiv sind.
Der Kontext kann auch die Suchanfragen beeinflussen, mit denen Informationen für eine Antwort abgerufen werden. Laut der Dokumentation zur ChatGPT-Suche können relevante gespeicherte Informationen verwendet werden, wenn eine Nutzeranfrage bei aktivierter Memory-Funktion in Suchanfragen überführt wird. Auch ein ungefährer Standort kann lokale Ergebnisse beeinflussen.
Jeden Durchlauf mit leerem Verlauf zu beginnen, kann für einen Test erster Antworten richtig sein. Dass im Test und in der realen Nutzung dasselbe Modell verwendet oder die Websuche aktiviert wird, zeigt nicht, dass alle anderen Bedingungen übereinstimmen. Wie gut sich ein kontrolliertes Ergebnis auf Nutzer mit anderen Verläufen und Einstellungen übertragen lässt, muss getrennt beurteilt werden.
Eine detaillierte Persona belegt kein Kundenverhalten
„Sarah, 40, Hochschulabschluss, verheiratet, zwei Kinder, lebt in London“ beschreibt ein Kundenprofil. Daraus geht nicht hervor, wie Sarah zwischen zwei Produkten wählen wird.
Wer ein defektes Gerät sofort ersetzen muss, kann sich anders verhalten als jemand, der die Küchenrenovierung für das nächste Jahr plant. Ein Kunde, der mehr bezahlt, um das Reparaturrisiko zu senken, kann zu einer anderen Entscheidung kommen als jemand mit einem knappen Budget. Auch technisches Wissen und Vertrautheit mit Marken können verändern, welche Aussagen glaubwürdig wirken.
Demografische Merkmale können relevant sein, doch ihre Verbindung zu einer Kaufentscheidung muss gezeigt werden. Ein detailliertes Profil beweist nicht, dass Kunden mit dem angenommenen Kaufverhalten tatsächlich beobachtet wurden.
Hypothetische Personas helfen dabei zu untersuchen, wie sich Antworten je nach angenommener Ausgangslage verändern. Sie zeigen nicht, wie häufig ein Szenario vorkommt, ob seine Annahmen gemeinsam auftreten oder ob Kunden tatsächlich wie beschrieben reagieren würden. Auf beobachtetem Kundenverhalten beruhende Profile bieten eine stärkere Grundlage. Mehr Profile allein schließen die Lücke nicht.
Nützliche Tests haben weiterhin Grenzen
Kontrollierte Tests können wertvoll sein, um Modellverhalten, das Auftauchen von Wettbewerbern und Veränderungen im Zeitverlauf zu beobachten. Sie können nicht jede mögliche Kundensituation nachbilden. Dennoch müssen die Testbedingungen die Deutung tragen, die aus den Ergebnissen gezogen wird.
Software zu entwickeln, die Antworten erfasst, Markennamen identifiziert und ein Dashboard anzeigt, ist etwas anderes als zu zeigen, dass eine Messung Kunden repräsentiert. Auch die Größe eines Unternehmens entscheidet diese Frage nicht. Ein kleines Team kann eine sorgfältige Methode entwickeln; die Daten einer großen Plattform zählen nur insoweit, wie sie die konkrete Behauptung stützen.
Eine gestiegene Empfehlungsrate in einem Test ist es wert, beobachtet zu werden. Ob sie auch in Gesprächen gilt, die Kunden tatsächlich führen, lässt sich nicht allein aus der Zahl der Wiederholungen bestimmen. Dieser Zusammenhang muss getrennt gezeigt werden.
Dieser Beitrag untersucht, wie gut Tests tatsächliche Kunden abbilden. Er beschreibt keine Umsetzungsmethode für ein alternatives Messsystem.
Wenn dieser Artikel hilfreich war
Ein Link von einer passenden Seite Ihrer Website oder das Teilen in sozialen Medien hilft diesem Artikel, mehr Menschen zu erreichen. Vielen Dank.
Hinweise zu Links und Marke →Über diesen Artikel
Dieser Beitrag wurde auf Grundlage der englischen Fassung redaktionell für die deutsche Ausgabe lokalisiert.
- Einsatz künstlicher Intelligenz
- Mit KI-Unterstützung — Evren Bal lieferte Argumentation, Beispiele und den inhaltlichen Rahmen. KI unterstützte die Quellenprüfung, die englische und deutsche Anpassung, Redaktion und Sprachprüfung. Auch die Titel- und Textillustrationen wurden mit KI erzeugt.
Ein kleines Experiment
Persönliche Messwerte werden geladen…