“Önceki Vibe Coder” Dönemi Başlıyor: Temiz Kodun Görünmezliği ve Yapay Zekanın Teknik Borç Faturası
Yazan Evren BalYayın tarihi · 7 dk okuma
Sayfayı kopyala
Yazılım dünyası son bir yıldır garip bir sarhoşluk içinde. Sosyal medya akışları, “10 dakikada sıfırdan SaaS uygulaması yaptım” videolarıyla, şirketlerin yönetim kurulu sunumları ise yapay zeka ajanlarının (AI agents) yazılım ekiplerinin yerini alacağını düşünen heyecanlı yöneticilerin sunumlarıyla dolu. Ancak bu coşkunun arkasında, kimsenin yüksek sesle konuşmak istemediği bir gerçek var.
Yapay zekanın kodlama hızıyla (yani o an hissettiğimiz o sahte üretkenlikle) bir ürünü gerçekten güvenli, performanslı ve sürdürülebilir şekilde yayına almak arasındaki uçurum her geçen gün büyüyor.
Ve bu gidişat, sektörü çok tanıdık ama bu kez faili farklı olan bir krizin eşiğine getiriyor: “Önceki Vibe Coder” (The Previous Vibe Coder) sorunu.
Her AI Destekli Kodlama Vibe Coding Değil
Burada önce kavramı daraltmak gerekiyor. Martin Fowler, vibe coding’i bir uygulamayı bir dil modeline tarif ederek üretmek, sonucu deneyip yeni komutlarla değiştirmek ama ortaya çıkan kodu incelememek olarak tanımlıyor. Ayırt edici nokta yapay zekânın kod yazması değil, geliştiricinin “kodun varlığını unutması.”
Deneyimli bir yazılımcının yapay zekâya kod yazdırırken mimariyi, testleri, güvenliği ve bakım sonuçlarını gözetmesi aynı çalışma biçimi değil. Fowler buna agentic programming diyor. Her AI destekli geliştirmeyi vibe coding diye adlandırırsak asıl riski gözden kaçırıyoruz: Kodu kimin ürettiğinden çok, ortaya çıkan sistemin anlaşılıp sınanması ve bir insan tarafından sahiplenilmesi önemli.
Bu yazıda “vibe coder” derken yapay zekâ kullanan her geliştiriciyi kastetmiyorum. Kodu anlamadan, kararları açıklayamadan ve canlı sonuçların sorumluluğunu taşıyacak doğrulamayı yapmadan ürüne dönüştüren çalışma biçiminden söz ediyorum.
Yapay Zeka Özensizliği Nasıl Sübvanse Ediyor?
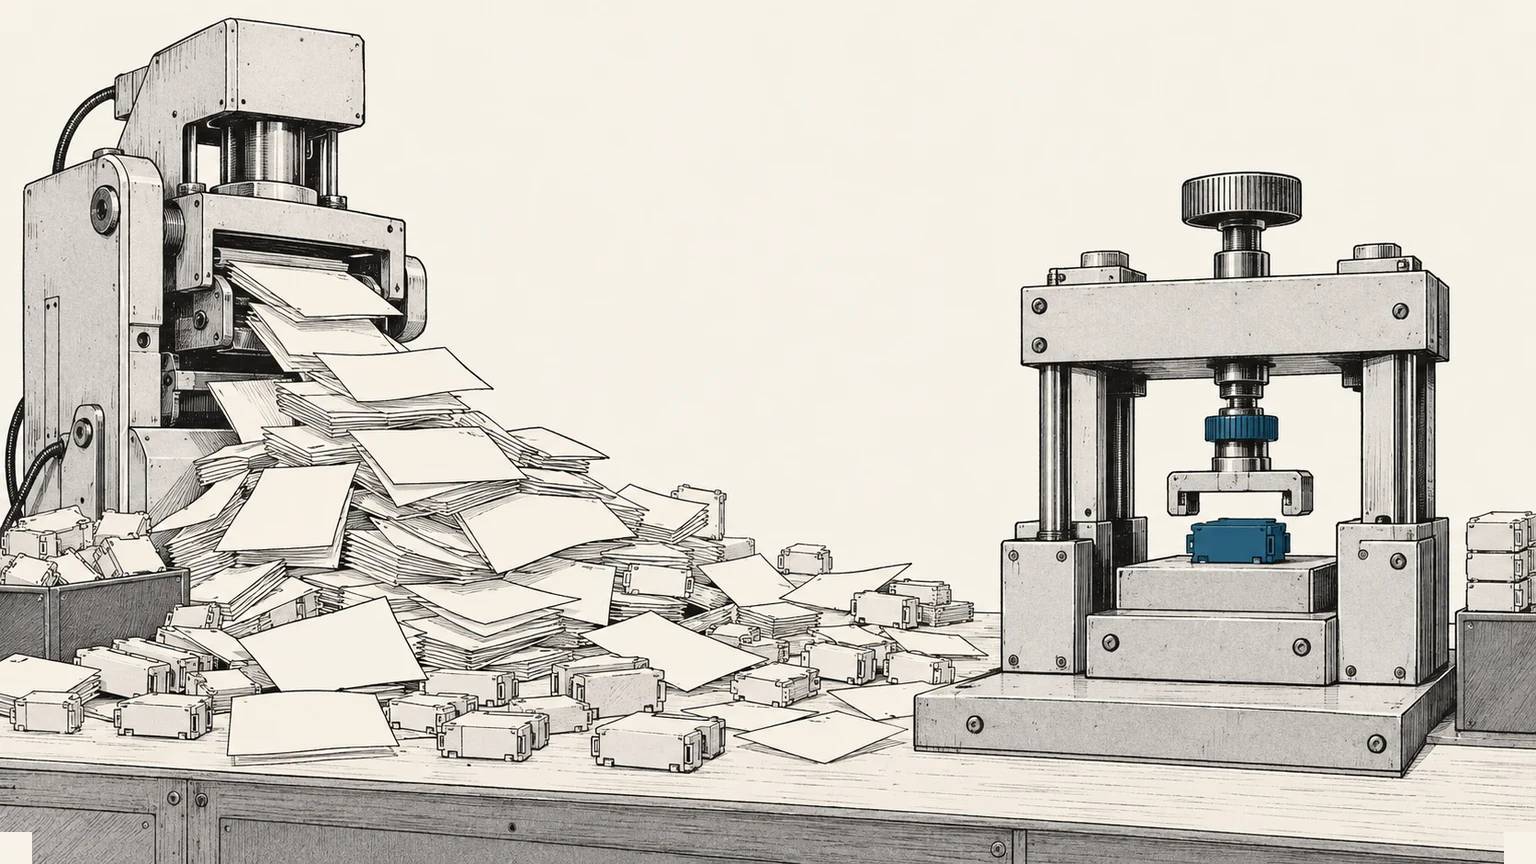
Yapay zeka kod üretme maliyetini düşürebilir; fakat özen göstermenin, test etmenin ve mimari kurmanın maliyetini ortadan kaldırmaz. Bu maliyetleri yalnızca ertelemeyi kolaylaştırabilir.
Bunu iktisadi terimlerle söylersek; yapay zeka kod üretme maliyetini (CAPEX) geçici olarak sıfırlarken, o kodun ilerideki bakım ve işletme maliyetini (OPEX) görünmez bir şekilde katlayarak artırıyor.
Bir geliştirici için test yazmak, güvenlik açıklarını taramak, sınır durumları düşünmek ve mimariyi korumak ciddi bir zihinsel efor ve zaman gerektirir. Yapay zeka ise bu eforu ortadan kaldırarak size saniyeler içinde “çalışıyor gibi görünen” kodlar verir.
"Ne var canım, yapay zeka da test yazıyor" diyorsanız temkinli olmanızı öneririm. Başarısız davranışı bir insan gözden geçirmeden modele bırakırsanız, kök nedeni çözmek yerine testi değiştirebilir. Ekranda her şey yeşil görünürken test, başarısızlığı da başarı sayacak kadar zayıflatılmış olabilir.
Buradaki anahtar kelime: Çalışıyor gibi görünen.
Geliştirici, kodun arkasındaki yapısal çürümeyi fark etmeden “hızlıca” bir sonraki özelliğe geçebilir. Yazılımdaki görünmeyen borç (OPEX) da sonra daha yavaş değişiklik, zor teşhis ve pahalı işletme olarak ortaya çıkabilir.
DRY Prensibinin Sessiz Ölümü ve Kütüphane Kaosu
Buradaki risk, her modelin ya da her AI destekli çalışma biçiminin kaçınılmaz kusuru değildir. Yapay zeka eksik proje bağlamıyla çalıştığında ve ekip yerelde makul görünen çözümü sistem mimarisine göre sınamadığında ortaya çıkar.
2025 tarihli bir araştırma ön baskısı, kurum içinde geliştirilen MVP'lerden gelen deneyimler ve yakın dönem sektör raporları üzerinden bunu akış–borç ödünleşimi olarak tanımlıyor: sürtünmesiz kod üretimi, mimari tutarsızlıklar, güvenlik açıkları ve daha yüksek bakım yüküyle birlikte görülebiliyor. Bu çalışma her AI destekli projenin aynı sonucu vereceğini kanıtlamıyor; ama endişenin nasıl oluştuğunu daha somut anlatıyor. Çalışmayı okuyun.
Bu yüzden yazılımın en temel kurallarından biri olan DRY (Don’t Repeat Yourself) prensibi, özellikle bu koşullarda sessizce aşınabiliyor.
Bir frontend projesinde yapay zekaya yeni bir sayfa çizdirdiğinizde sıklıkla şu senaryo yaşanır:
- Sayfa A: Projeye X kütüphanesi eklenir ve oradaki hazır bir bileşen (component) import edilir.
- Sayfa B: Yapay zeka o kütüphanenin varlığını unutur ve aynı bileşenin işlevini başka bir sayfada inline (satır içi) olarak sıfırdan yazar.
- Sayfa C: Aynı işlev için tamamen farklı bir mantıkla üçüncü bir inline fonksiyon uydurur.
Sonuçta proje hem gereksiz paketlerle doluyor hem de aynı işi yapan spagetti kodlarla şişiyor. Bu durum, kullanıcının tarayıcısına inen paket boyutunu (bundle size) büyüterek sayfa yüklenme hızını ve web performansını doğrudan baltalar. Bir bug çıktığında ise bunu projenin 10 farklı yerinde arayıp düzeltmek zorunda kalıyorsunuz. "Ben kurallarımı, ajan tanımlarımı buna göre yazarım, öyle hatalar yapmaz" demeyin, maalesef yapıyor. Ve maalesef gerçek dünyada sorunları "haklısın, üzgünüm, benim hatam" yazarak çözmüş olmuyoruz.
Aynı durum backend'de de geçerli. Projenizde Route → Handler → Service → Repository şeklinde temiz bir mimari varken, yapay zeka en kolay yolu seçip doğrudan route tanımının içine SQL sorgusunu ya da database çağrısını gömüveriyor. Kod o gün çalışıyor ama arkasında cache mekanizmaları bypass edilmiş, doğrulama kuralları atlanmış ve test edilemez hale gelmiş bir enkaz bırakıyor.
Görünmez Kalitenin Değersizleşmesi
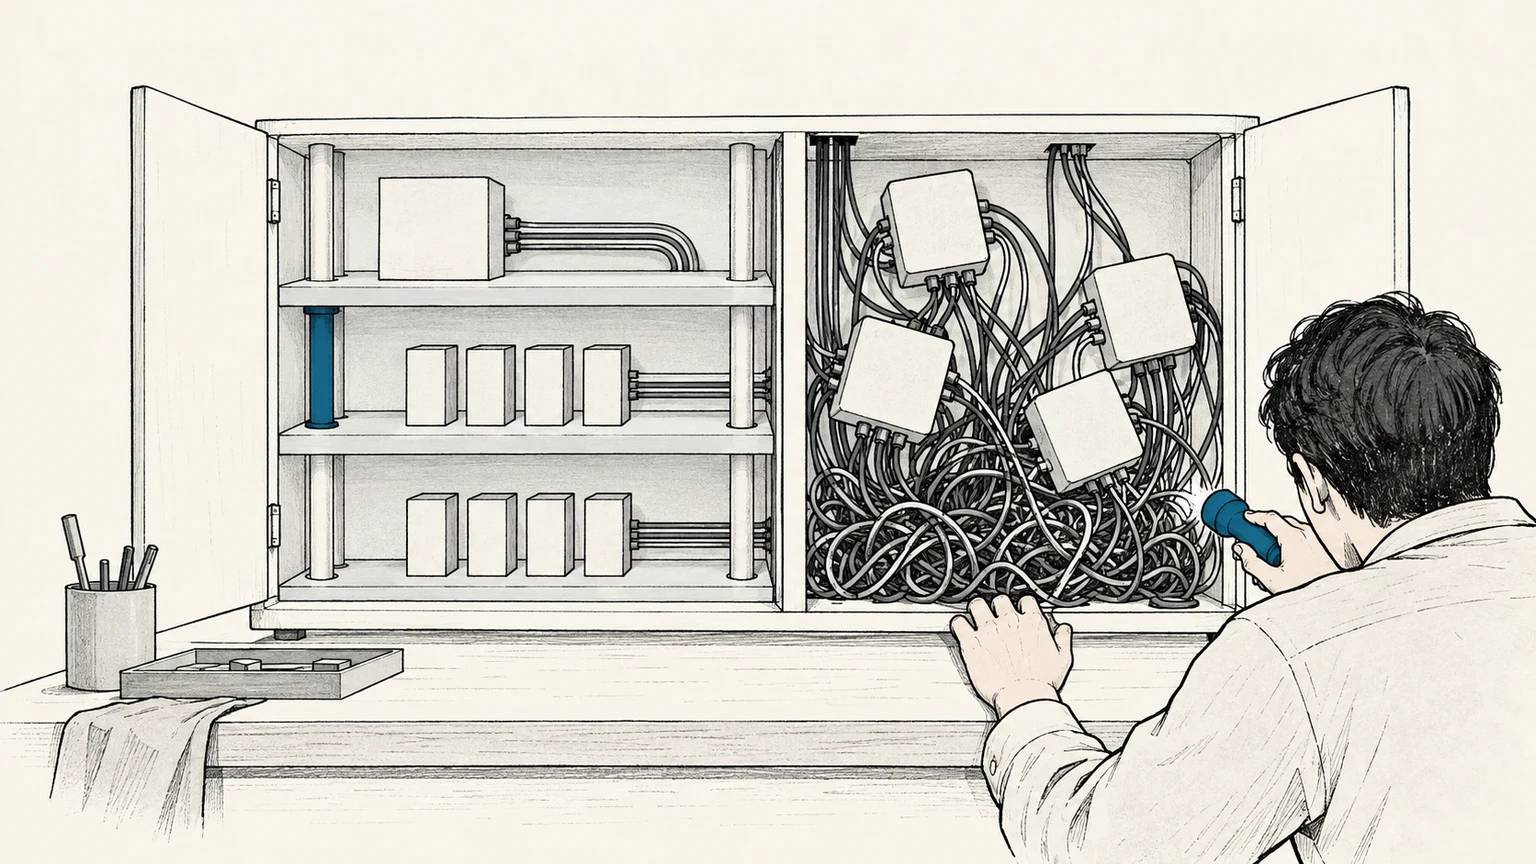
Yazılımda iyi mühendislik kalitesi negatif alan gibidir; varlığıyla değil, yokluğuyla anlaşılır.
Veritabanınız çalınana kadar kimse güvenli kod yazmak için harcadığınız zamana değer vermez. Ya da yapay zekanın yazdığı verimsiz bir arka plan döngüsü kullanıcının cihaz şarjını saatte %5 tüketirken, optimize edilmiş temiz kod sadece %1 tüketir. Kullanıcı bunu doğrudan fark etmez ama arkada sessizce cihazın ömründen yer. O backend'e saatte 3 kişi girerken düzgün çalışıyordur ama anlık 80 kişi girdiğinde çalışması için biraz daha fazlası gerekir.
İktisatçı George Akerlof'un “Limonlar Pazarı” (Market for Lemons) teorisindeki gibi; alıcı (yani şirket yöneticisi veya kullanıcı) kodun iç kalitesini göremediği için piyasa hızlıca üretilmiş kalitesiz "limonlar" ile dolar ve iyi mühendislik görünmez hale gelir.
Pazar, yapay zeka ile üretilmiş hızlı ama özensiz ürünlerin gürültüsüyle boğuldukça, bu görünmez kaliteler ekonomik olarak cezalandırılmaya başlar. Temiz, güvenli ve performanslı kod yazmak için uğraşan mühendislerin emeği, “bakın biz AI ile 10 dakikada yaptık” diyenlerin gölgesinde kalır. Ta ki o ilk büyük siber saldırıya veya ölçeklenme krizine kadar.
“Önceki Vibe Coder” Sorunu
Sektörde işe yeni giren yazılımcının kod tabanına bakıp “benden önceki yazılımcı her şeyi spagetti yapmış” demesi klasik bir şakadır. Şimdi bu şakaya yeni bir aktör katılıyor: “Benden önceki vibe coder.”
Şirketler bugün yapay zeka ile ucuza ürün çıkardıklarını düşünebilir. Olası sonuçlardan biri, daha sonra yeni özellik eklemek ya da kritik bir hatayı çözmek istediklerinde karşılarında zayıf standartları ve sınırlı insan bilgisi olan bir teknik borç bataklığı bulmalarıdır.
O noktada o spagetti yığınını temizlemek ve yeniden yapılandırmak (refactoring) için pahalı kıdemli müdahalesi gerekebilir. Bu bir öngörüdür, evrensel bir kehanet değil: yazılım geliştirme maliyeti düşmekten çok faturası ertelenmiş olabilir.
Modeller Gelişince Ne Olacak? (Jevons Tuzağı)
Teknoloji iyimserleri gelecekte modeller geliştikçe bu sorunların kendiliğinden çözüleceğini iddia ediyor. “Bunlar bugünün modellerinin (GPT-5.6, Fable 5) sorunları. Gelecekte modeller mükemmelleştiğinde bu hatalar da yok olacak” teziyle geliyorlar. Fakat bu iddia iki temel gerçeği ıskalıyor:
İstem Eşdeğerliği Yasası
Yapay zeka ne kadar akıllı olursa olsun, ona ne yapacağını söyleyen girdi yine bir insandan çıkacaktır. Çok karmaşık bir sistemi hatasız ve eksiksiz şekilde tarif etmek (specification), günün sonunda o sistemi kodlamaktan daha az efor gerektirmez. Yapay zekaya “bana bir ödeme sistemi yaz” demek yetmez; tüm iade koşullarını, vergi kurallarını, sahtekarlık (fraud) algoritmalarını tek tek ve kusursuzca tanımlamak zorundasınız. Bu tarif süreci aslında yeni nesil bir kodlamadır ve insan hatasına yine açıktır.
DÜZENLEME — 5 Eylül 2026: Bu bölüme sonradan bir nokta ekledim. Specification’ı yazmak kadar, ekip içinde nasıl saklandığı ve gözden geçirildiği de önemli. Wei Zhang ve Jessie Jie Xia, Structured-Prompt-Driven Development yazısında niyet ve kısıtların promptlarla birlikte sürüm kontrolünde tutulmasını öneriyor. Böylece tarif, sohbet geçmişinde kalan tek kullanımlık bir metin değil, ekibin inceleyip değiştirebildiği bir kayıt oluyor.
Bu, specification hazırlama yükünü ortadan kaldırmıyor. Yazı, Thoughtworks içindeki bir yöntemi anlatıyor. Yöntemin hızı, kaliteyi, güvenilirliği, maliyeti veya yatırım getirisini artırdığını bağımsız bir karşılaştırmayla göstermiyor.
Jevons Paradoksu ve Karmaşıklığın Korunumu
Kömür motorları daha verimli hale geldiğinde dünyadaki kömür tüketimi azalmadı; aksine kömürle çalışan makine sayısı patladığı için tüketim katlanarak arttı. Yapay zeka modelleri geliştikçe ve kod yazmak ucuzladıkça daha az kod yazmayacağız. Aksine, sistemlerin boyutu ve karmaşıklığı katlanarak büyüyecek. AI 10 kat akıllandığında biz de 10 kat daha karmaşık sistemler inşa edeceğiz. Dolayısıyla karmaşıklık yok olmayacak, sadece seviyesi yükselecek.
Ve en önemlisi, yapay zekanın gerçek dünya sorumluluğu (skin in the game) yoktur. Yapay zeka hata yaptığında AWS faturasını ödemez, gece 3'te alarm sesiyle uyanmaz ya da siber saldırı sonrası mahkemeye çıkamaz. Sorumluluk devredilemeyen tek şeydir ve mühendislik sadece kod yazmak değil, o kodun sorumluluğunu üstlenmektir.
Bu ayrımı, Rest of World'ün sıradan insanların yapay zekayı işlerinde nasıl kullandığını anlatan haberinde de görmek mümkün. Haberde kodlama deneyimi olmayan bir kişisel antrenörün Claude ile kendi işine yardımcı olan bir uygulama geliştirdiği, küçük işletme sahiplerinin de fiyatlama ve operasyon işlerini yapay zekayla desteklediği anlatılıyor. Bunlar değerli ve gerçek kullanım örnekleri olabilir; ancak bir prototipin ya da sahibinin işini kolaylaştıran özel bir aracın, güvenilir ve herkese açık bir ürüne dönüştüğü anlamına gelmez. İkinci aşamada hâlâ mimari kararları verecek, güvenliği ve performansı sınayacak, hataları yönetecek ve yayındaki sistemin sorumluluğunu üstlenecek bir mühendis gerekir.
Sonuç
Yapay zeka yazılım mühendisliğini bitirmiyor; tam aksine mimari vizyonun, disiplinin ve kalitenin önemini her zamankinden daha fazla artırıyor.
Yapay zeka ile hızlı ama özensiz kod üretenlerin teknik borç faturası kesilmeye başlandığında, kazananlar yine o karmaşayı ehlileştirmeyi bilen, sorumluluk sahibi mühendisler (gerçek uygulayıcılar) olacak.
Bu yazıyı faydalı bulduysanız
Web sitenizde ilgili bir içerikten bu yazıya bağlantı vermeniz ya da sosyal medyada paylaşmanız, daha fazla kişiye ulaşmasına gerçekten yardımcı olur. Desteğiniz için teşekkür ederim.
Bağlantı ve marka kullanım rehberi →Bu yazı hakkında
- Yapay zekâ kullanımı
- Yapay zekâ desteği kullanıldı — Bu yazıya 7 Eylül 2026'da eklenen vibe coding tanımı ve üç dilli uyarlama, Evren Bal'ın onayladığı kapsam doğrultusunda yapay zekâ desteğiyle hazırlandı. Nihai editoryal sorumluluk Evren Bal'a aittir.
Küçük bir deney
Kişisel metrikler yükleniyor…