Was kann KI in der CRO-Recherche automatisieren?
Von Evren BalVeröffentlicht · 7 Min. Lesezeit
Seite kopieren
Bei uns im Unternehmen war das Anliegen konkret: Niemand sollte die Sitzungsaufzeichnungen in Clarity einzeln ansehen müssen. KI sollte sie alle prüfen, zeigen, wo Besucher hängen bleiben, und sagen, welche Seiten wir verbessern sollten.
Aufzeichnungen zu sichten kostet Zeit. Bei vielen Sitzungen kann niemand jede mit derselben Aufmerksamkeit prüfen. Wenn diese Last sinkt, bleibt dem Team mehr Zeit, die gefundenen Probleme zu lösen. KI um Hilfe zu bitten, ist deshalb nachvollziehbar.
In dieser Erwartung stecken jedoch mehrere unterschiedliche Aufgaben: auf die Aufzeichnungen zugreifen, Verhalten über viele Sitzungen vergleichen, entscheiden, ob ein Verhalten tatsächlich ein Problem zeigt, und prüfen, ob eine vorgeschlagene Änderung wirkt.
Conversion-Rate-Optimierung, kurz CRO, soll Besuchern helfen, eine gewünschte Handlung wie einen Kauf oder eine Bewerbung einfacher abzuschließen. Eine Liste von Seiten mit Verbesserungsbedarf beendet diese Arbeit nicht. Wir müssen weiterhin wissen, welches Problem für wen und warum wichtig ist.
CXL beschreibt den Einsatz von KI in der CRO-Recherche anhand eines Workshops. Dort bewertet KI Nutzerwege nach Prinzipien der Gebrauchstauglichkeit, ordnet Forschungsergebnisse Themen zu und entwickelt Testideen. Der gesamte Forschungsprozess wird nicht an ein Modell abgegeben. Menschen prüfen Zwischenergebnisse, ergänzen fehlenden Kontext und entscheiden über Prioritäten.
Das ist ein Bericht über einen Workshop, kein Nachweis dafür, dass dieses Vorgehen in jedem Unternehmen die Conversion erhöht. Eine wichtige Warnung des Artikels lautet: KI kann detaillierte Bewertungen wie gemessene Ergebnisse aussehen lassen. Ein niedriger Wert für eine Seite beweist nicht, dass sie tatsächlich Umsatz kostet.
Eine Clarity-Anbindung gibt keinen Zugriff auf Aufzeichnungen
Bei diesem Anliegen liegt das erste Hindernis vor der Interpretation: Welche Daten kann das Modell überhaupt erreichen?
Die Dokumentation der Clarity Data Export API beschreibt die extern verfügbaren Daten als Dashboard-Daten. Dazu gehören zusammengefasste Kennzahlen wie Besucherzahlen, Scrolltiefe und wiederholte Klicks. Die API stellt einem externen KI-System keine Rohdaten aus Sitzungsaufzeichnungen bereit, die sich gebündelt verarbeiten ließen.
Auch was wir auf dem Bildschirm ansehen, ist wichtig. Laut den offiziellen Clarity-FAQ zeichnet Clarity die Dokumentobjektstruktur einer Seite, das DOM, und Interaktionen wie Klicks und Scrollen auf. Daraus rekonstruiert Clarity eine Sitzung im eigenen Player. Dieses Replay ist keine Videodatei, die sich einfach einer externen KI übergeben lässt. Die FAQ sagt außerdem, dass einzelne Aufzeichnungen nicht heruntergeladen werden können.
Die Möglichkeit, eine Aufzeichnungsliste als CSV zu exportieren, hebt diese Grenze nicht auf. Die Datei enthält für jede Aufzeichnung eine Zusammenfassung und einen Link. Sie gibt einem externen Modell nicht alles, was in diesen Sitzungen passiert ist.
Die Rohdaten durch Reverse Engineering der internen Datenflüsse des Players zu beschaffen, ist ebenfalls kein akzeptabler Weg. Die Nutzungsbedingungen von Microsoft Clarity untersagen Reverse Engineering und Versuche, technische Beschränkungen zu umgehen. Ein inoffizielles Verfahren zum Abruf dieser Daten kann damit in Konflikt stehen.
Zugleich wäre eine Verbindung ohne offizielle Datenschnittstelle fragil. Ändert Clarity eine interne Serviceadresse oder ein Datenformat, bricht sie. Dieses Anliegen über interne Datenflüsse zu lösen, ist weder unter den Nutzungsbedingungen noch als belastbarer Betriebsweg akzeptabel.
Zwischen einer Verbindung zu Dashboard-Daten und dem Abruf der Daten, die nötig wären, um das Verhalten jedes Besuchers zu untersuchen, liegt deshalb eine große Lücke. Zusammenfassungen können Seiten nennen, die eine Untersuchung verdienen. Sie erklären allein weder, was ein Besucher dort erlebt hat, noch warum er die Aufgabe abgebrochen hat.
Computer Use schließt diese Lücke nicht
Computer Use bezeichnet KI, die einen Bildschirm sieht und über Maus und Tastatur handeln kann. Eine Aufzeichnungsliste zu öffnen, ein Replay im Clarity-Player zu starten und die sichtbare Aktivität zu deuten, könnte Teil eines solchen Ablaufs sein.
Der Zugriff auf den Player verschafft dem Modell jedoch keinen Zugriff auf Rohdaten der Replays. Er verwandelt auch nicht Tausende Sitzungen in vergleichbare Datensätze für eine gebündelte Analyse. Die Sitzungen müssen weiterhin nacheinander geöffnet, angesehen und notiert werden.
Stellen wir uns vor, ein Agent soll auf diese Weise 100.000 Aufzeichnungen ansehen. Dann sitzt ein Agent vor dem Bildschirm statt eines Menschen. Das Öffnen, Abspielen und Prüfen jeder Sitzung verschwindet nicht. Ebenso wenig wäre es verlässlich, von einem Modell zu erwarten, dass es in einem einzigen Arbeitslauf jedes relevante Detail festhält und am Ende sauber vergleicht.
Dafür bräuchte es ein eigenes System, das Befunde speichert, nach einheitlichen Kriterien einordnet und später zusammenführt. Es müsste auch prüfen, welche Momente übersehen oder falsch gedeutet wurden. Computer Use zu aktivieren, baut dieses Analysesystem nicht von selbst.
Einige ausgewählte Sitzungen zu prüfen und den gesamten Verkehr zu analysieren, sind Aufgaben unterschiedlicher Größenordnung. Im ersten Fall kann ein bildschirmgestützter Assistent nützlich sein. Im zweiten muss das Team zuerst klären, welche Daten tatsächlich zugänglich sind und wie sie verarbeitet werden können. Dies ist kein Bericht über ein abgeschlossenes Experiment zur Auswertung von Aufzeichnungen, sondern eine Einschätzung der Grenzen dieses Ansatzes.
Zwei Zusammenfassungen zu vergleichen, spart womöglich nicht die gesuchte Arbeit
Bleibt nur, die Zusammenfassungen aus Clarity und GA4 nebeneinanderzulegen und zu deuten, verändert sich auch der Wert der Automatisierung. Gespart werden sollte die Zeit, die für die Prüfung einzelner Aufzeichnungen anfällt. Zwei Dashboard-Zusammenfassungen zu vergleichen, ist eine seltenere Aufgabe, die ein Mensch leicht erledigen kann.
KI kann daraus einen gut formulierten Bericht machen. Trotzdem muss jemand prüfen, ob derselbe Zeitraum und dieselbe Besuchergruppe verglichen wurden. Eine Erklärung, die überzeugend klingt, wird dadurch nicht richtig.
Von dieser engeren Nutzung würde ich keinen großen Effizienzgewinn erwarten. Die Vorbereitung kann etwas weniger Zeit kosten, die Prüfung bleibt aber bestehen. Vor allem löst sie nicht die Sichtung der Aufzeichnungen, die ursprünglich so viel Zeit gekostet hat. Der Wert einer Automatisierung sollte an der Last gemessen werden, die sie senken soll.
Nützlicher ist es, Befunde in eine prüfbare Hypothese zu verwandeln
Wenn das Material für die Recherche tatsächlich zugänglich und maschinell verarbeitbar ist, ergeben sich andere Möglichkeiten. Antworten aus Umfragen und Gesprächsnotizen lassen sich untersuchen. Ein Modell kann ähnliche Beobachtungen gruppieren, zusammenpassende Befunde verbinden und Fragen für die weitere Recherche vorschlagen. Für eine quantitative Analyse des Nutzerverhaltens muss die Datenbasis jedoch erst gestaltet werden.
Nehmen wir ein Bewerbungsformular, das verbessert werden soll. Zuerst legt die für CRO verantwortliche Person oder der Eigentümer des Formulars die Geschäftsfrage fest: Welche Formularfehler hängen damit zusammen, dass Menschen die Bewerbung abbrechen? Danach entscheidet diese Person, welche Nutzerereignisse wann und wie erfasst werden. Dass ein Fehler erscheint, ein Nutzer ihn korrigiert und die Bewerbung abschließt, kann Teil dieses Plans sein.
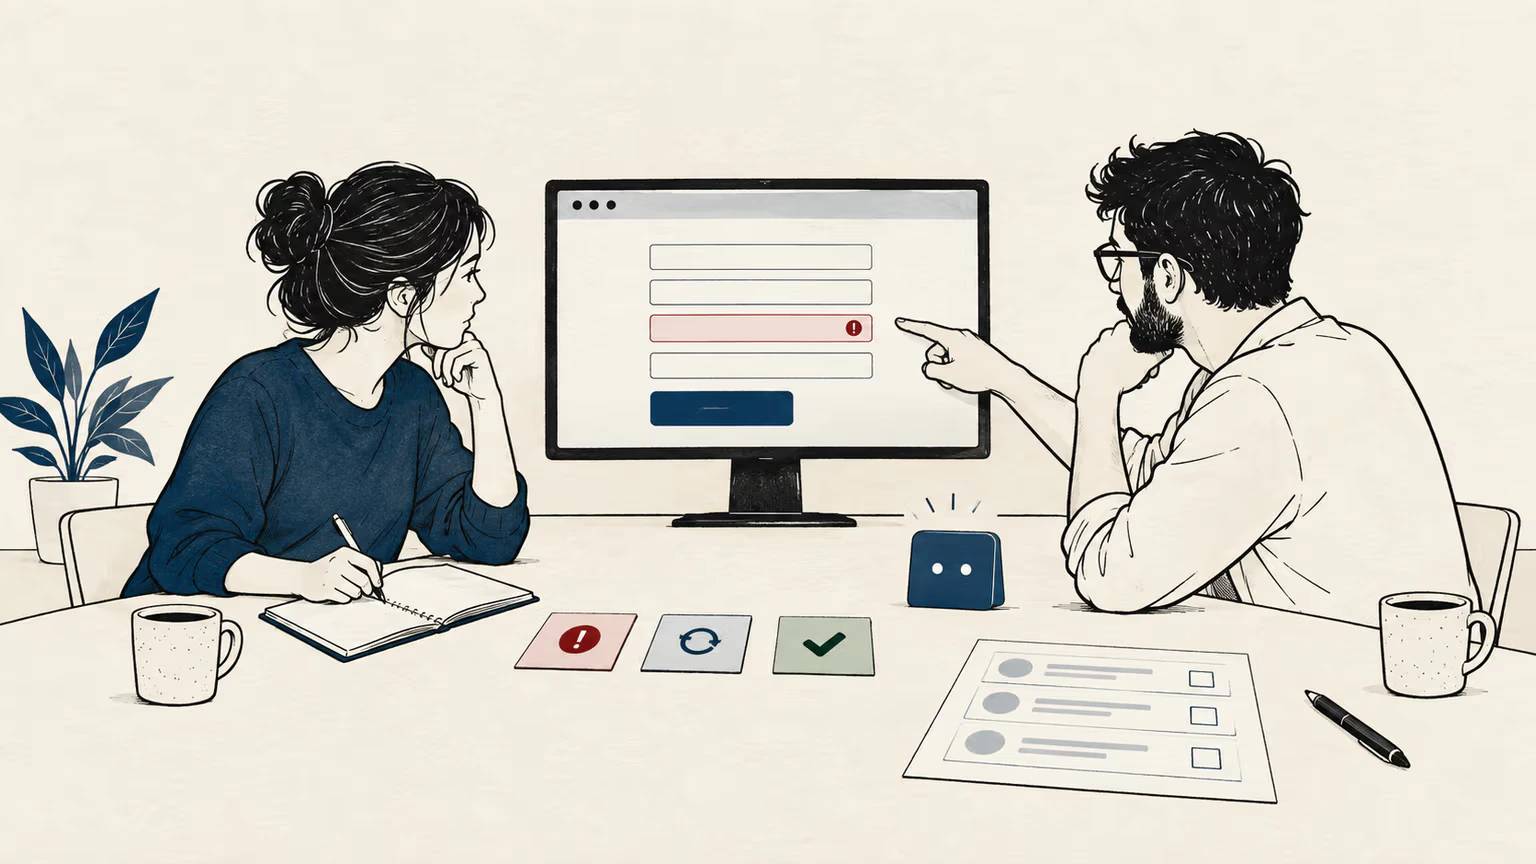
Das Softwareteam setzt den Messplan um und übergibt diese Ereignisse an das Analysesystem. Es muss geprüft werden, ob die Aufzeichnungen das erwartete Verhalten korrekt abbilden. Die Verantwortung bleibt beim Eigentümer der Seite oder des Ablaufs. Was gemessen werden soll, entscheidet nicht das Softwareteam und auch nicht die KI.
Erst dann lässt sich berechnen, ob die Abbruchrate nach bestimmten Fehlern steigt. Dafür müssen nicht alle Sitzungen am Bildschirm wiedergegeben werden. Ohne Messung sollten wir jedoch nicht annehmen, dass diese detaillierten Daten bereits vorliegen.
KI kann helfen, die Ergebnisse zusammen mit Nutzerkommentaren zum Formular zu deuten. Sie kann Hinweise auf unklare Anweisungen mit Fehlern im selben Feld zusammenführen und daraus eine Hypothese ableiten. Jemand muss weiterhin prüfen, ob die Kommentare von der relevanten Nutzergruppe stammen und die Ereignisse korrekt erfasst wurden.
In diesem Beispiel übernimmt die Software die Berechnung. Das Modell ordnet das Forschungsmaterial und entwickelt mögliche Erklärungen. Das Team vergleicht eine vorgeschlagene Erklärung mit dem tatsächlichen Verhalten der Seite. Das Problem kann an einer unklaren Formulierung liegen oder an einer fehlerhaften Validierungsregel. Dasselbe Abbruchsignal trennt diese Fälle nicht.
Ist die Hypothese plausibel, legt der Eigentümer der Seite oder des Ablaufs die Änderung und das Erfolgskriterium fest. Das Team führt einen passenden Test durch und bewertet das Ergebnis. Eine von KI vorgeschlagene Änderung verdient die Bezeichnung Verbesserung erst, wenn das Ergebnis besser ist. Zuvor ist sie ein Kandidat.
Die Erwartung, KI anzubinden, CRO nicht mehr selbst machen zu müssen und einen fertigen Verbesserungsbericht zu erhalten, überspringt diese Arbeit. Teile der Recherche lassen sich beschleunigen. Mit zugänglichen Daten können bestimmte Analysen sogar regelmäßig laufen. Die Verantwortung dafür, was ein Ergebnis bedeutet und ob eine Empfehlung trägt, bleibt jedoch beim Team.
Für dieses Anliegen ist der sinnvolle Anfang nicht die Suche nach einem Agenten, der jede Aufzeichnung ansieht. Zuerst muss klar sein, welche Daten nötig sind, um zu verstehen, wo ein Besucher Schwierigkeiten hat. Dann lässt sich prüfen, welchen Teil der Analysearbeit KI tatsächlich übernehmen kann. Die Arbeit wird nicht dadurch besser, dass ein längerer Bericht entsteht. Sie wird besser, wenn das Team mit weniger Aufwand eine bessere Hypothese prüfen kann.
Wenn dieser Artikel hilfreich war
Ein Link von einer passenden Seite Ihrer Website oder das Teilen in sozialen Medien hilft diesem Artikel, mehr Menschen zu erreichen. Vielen Dank.
Hinweise zu Links und Marke →Über diesen Artikel
Dieser Beitrag wurde auf Grundlage der englischen Fassung redaktionell für die deutsche Ausgabe lokalisiert.
- Einsatz künstlicher Intelligenz
- Mit KI-Unterstützung — Dieser Artikel entstand aus dem von Evren Bal beschriebenen Geschäftsbedarf und seiner Einschätzung. KI unterstützte die Quellenprüfung, den Entwurf und die redaktionellen Kontrollen. Die Titelillustration wurde mit KI erstellt.